Konsistente Figur KI Video: So bleibt das Gesicht in jedem Clip gleich
Eine konsistente Figur im KI-Video bedeutet: gleiches Gesicht, gleiche Haare und gleiches Outfit in jeder Einstellung. Hier erfährst du, warum Figuren abdriften und mit welchem Workflow aus Referenzbild und Prompt du das verhinderst.
Geschrieben von Vincent Park
Veröffentlicht
Eine konsistente Figur im KI-Video bedeutet: dieselbe Person oder dasselbe Wesen, mit gleichem Gesicht, gleichen Haaren, gleicher Statur und gleichem Outfit, in jedem Clip, den du erzeugst. Das gelingt, wenn du jede Einstellung vom selben Referenzbild aus startest, die Figur in einer kurzen, wiederholbaren Beschreibung festhältst und ein Modell wählst, das referenzbasierte Generierung unterstützt, etwa Wan 3.0 in VIBE. Diese Anleitung zeigt den ganzen Workflow samt Prompts zum Kopieren.
In einem Satz
Konsistente Figur KI Video heißt: Du erzeugst mehrere Clips, in denen eine Figur dasselbe Gesicht, dieselben Haare, dieselbe Körperform und dieselbe Kleidung behält, indem du jede Generierung am selben Referenzbild und an derselben festen Textbeschreibung verankerst.
Was bedeutet eine konsistente Figur im KI-Video?
Jedes KI-Videomodell erzeugt jeden Clip von Grund auf neu. Gibst du ihm nichts Festes an die Hand, erfindet es jedes Mal ein neues Gesicht: Die Heldin, die in Clip eins eine Frau mit grüner Jacke ist, wird in Clip zwei zu einer anderen Frau in hellerem Mantel. Eine konsistente Figur im KI-Video entsteht durch Gewohnheiten, die diesen Zufall beseitigen: ein festes Referenzbild, eine feste Textbeschreibung und ein Modell, das beides respektiert.
Am wichtigsten ist das bei allem, was aus mehr als einer Einstellung besteht: eine Kurzgeschichte, ein Maskottchen, das in jedem Post auftaucht, ein Produkterklärvideo mit wiederkehrendem Presenter oder eine wöchentliche Serie auf TikTok oder YouTube Shorts. Für einen einzelnen Clip kannst du das meiste davon überspringen. Für eine Serie macht es den Unterschied zwischen einem Kanal mit wiedererkennbarem Gesicht und einem Feed aus zusammenhanglosen Clips.
Warum verändern sich KI-Figuren von Clip zu Clip?
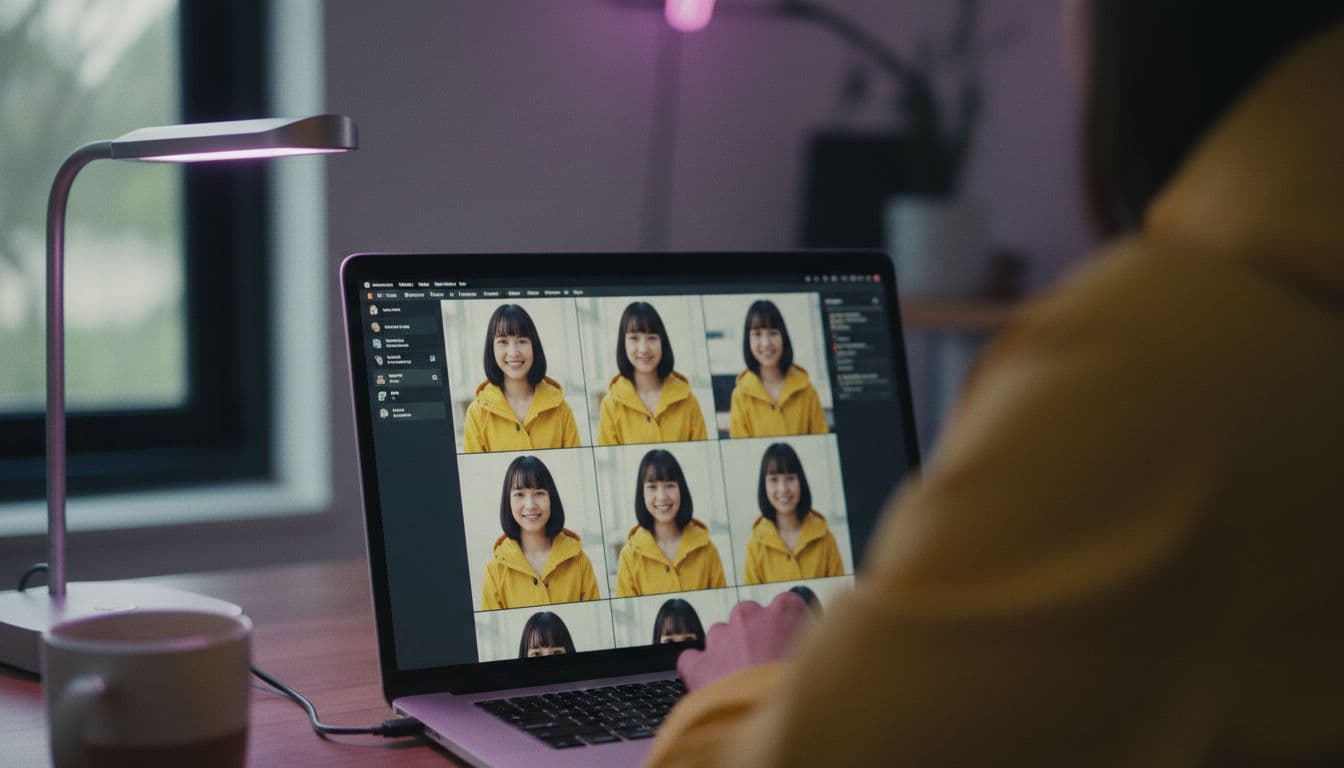
Text-zu-Video-Modelle verwandeln deine Worte per Sampling in Pixel, und eine Beschreibung wie „eine junge Frau in grüner Jacke“ passt auf Tausende verschiedene Gesichter. Jede neue Generierung wählt ein anderes. Innerhalb eines kurzen Clips kann das Modell ein Gesicht meist stabil halten, über mehrere Clips hinweg verbindet aber nichts die Ergebnisse, solange du diese Verbindung nicht selbst herstellst.
- Vage Beschreibungen. „Ein junger Mann“ lässt dem Modell jedes Mal freie Wahl bei Alter, Gesichtsform, Haaren und Hautton.
- Kein visueller Anker. Ein reiner Text-Prompt gibt dem Modell kein Bild zum Nachbilden, also wird die Identität pro Clip neu erfunden.
- Wechselnder Kontext. Neues Licht, ein anderer Kamerawinkel oder ein neuer Ort verleiten das Modell dazu, Kleidung und Gesichtsdetails neu zu zeichnen.
- Lange Clips. Je länger eine Generierung läuft, desto mehr Raum gibt es für schleichendes Abdriften, etwa eine veränderte Frisur oder Farbverschiebungen.
- Gemischte Modelle. Zwei verschiedene Modelle zeichnen aus demselben Satz nie dasselbe Gesicht.
Wie behältst du dieselbe Figur im KI-Video?
Am zuverlässigsten ist es, das Modell nicht in jedem Clip die Figur erfinden zu lassen, sondern ihm ein fertiges Bild der Figur zu geben. Genau das leistet Image-to-Video: Das Foto legt Gesicht und Outfit fest, und der Prompt muss nur noch die Bewegung beschreiben. Die Grundlagen findest du in unserer Anleitung zu Image-to-Video, hier kommt die Variante speziell für Figuren.
- Erstelle ein sauberes Hero-Bild. Am besten funktioniert ein frontales, gleichmäßig ausgeleuchtetes Halbporträt der Figur vor einfachem Hintergrund. Nimm ein eigenes Foto, eine Illustration oder ein generiertes Bild.
- Schreibe einen Figuren-Anker. Zwei kurze Sätze mit Altersspanne, Haaren, Kleidung und einem markanten Detail. Halte ihn in jedem Prompt wortgleich.
- Erzeuge jede Einstellung aus dem Hero-Bild. Starte jeden Clip mit demselben Bild und ändere nur Handlung, Kamera und Setting.
- Halte jeden Clip kurz. Plane wenige Sekunden pro Einstellung und schneide dazwischen, statt eine lange Einstellung zu drehen, in der sich Abweichungen aufbauen können.
- Bleib beim selben Modell. Wähle für die Serie ein Modell und bleib dabei, damit sich der Look nicht verschiebt.
- Speichere deine besten Frames. Endet ein Clip mit einem tollen Frame der Figur, exportiere ihn und nutze ihn als Hero-Bild für die nächste Einstellung.
 Wan 2.6
“Using the reference image: the same woman with short dark hair and a green bomber jacket walks toward the camera along a rainy city street at dusk, gentle handheld tracking shot, neon reflections on wet pavement. Keep her face, hair and jacket unchanged.”
Wie schreibst du einen Figuren-Anker, der immer gleich bleibt?
Ein Figuren-Anker ist ein kurzer, fester Textblock, der deine Figur beschreibt und unverändert an den Anfang jedes Prompts kopiert wird. Er funktioniert, weil er dem Modell den Spielraum zum Improvisieren nimmt. Unsere Anleitung zum Schreiben von KI-Video-Prompts erklärt die Formel aus Subjekt, Handlung, Kamera und Licht; der Anker ist schlicht der eingefrorene Subjekt-Teil.
Ein guter Anker ist genau bei dem, was das Auge zuerst bemerkt, und schweigt zu allem, was sich zwischen den Einstellungen ändern soll. Nenne Haare, Kleidung, Altersspanne und ein Erkennungsmerkmal. Lass Stimmung, Handlung und Ort weg, denn die gehören zur jeweiligen Einstellung.
 Seedance Pro Fast
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat. Mira sits at a café window and slowly turns a coffee cup in both hands, soft morning light, static medium shot, shallow depth of field.”
- Verwende in jedem Prompt denselben Namen für die Figur; ein Name dient dem Modell als Anhaltspunkt.
- Nenne die Kleidung immer in derselben Reihenfolge: Oberteil, Oberbekleidung, Accessoires.
- Bevorzuge konkrete Farben („senfgelber Regenmantel“) vor vagen Wörtern („bunter Mantel“).
- Ändere pro Einstellung nur eine Sache, entweder Handlung oder Ort, niemals die Figur.
Was ist Reference-to-Video, und welches Modell unterstützt es?
Reference-to-Video ist ein Generierungsmodus, bei dem das Modell ein oder mehrere Referenzbilder, manchmal auch Videos oder Audio, erhält und die darin gezeigte Identität beibehält, während es neue Bewegung erzeugt. Das geht einen Schritt weiter als Image-to-Video, denn die Referenz gilt als Figur, die wiederverwendet wird, und nicht als erstes Bild, das animiert wird. Stand Oktober 2026 ist Wan 3.0 das deutlichste Beispiel: Alibaba beschreibt den Reference-to-Video-Modus so, dass Gesichtszüge, Frisur, Körperform, Kleidung und Accessoires einer Figur konsistent bleiben, ebenso Requisiten, Räume und Stil. Details stehen in Alibaba Clouds Wan-3.0-Ankündigung.
Drittanbieter-Plattformen, die das Modell hosten, nennen bis zu 10 Referenzbilder, eine maximale Länge von 30 Sekunden und 1080p-Ausgabe; die genauen Grenzen hängen davon ab, wo du es nutzt. Der Reference-to-Video-Modus ist eine Fähigkeit des Modells und kein Versprechen für die Oberfläche einer bestimmten App. In VIBE ist der verlässliche Weg derzeit ein starkes Hero-Bild in Image-to-Video, mit Wan 3.0 als erstem Modell zum Ausprobieren. Alle Modelle siehst du in der VIBE-Modellliste, und über die WAN-Familie kannst du mehr lesen. (Alibaba Cloud)
Welches KI-Videomodell hält Figuren am konsistentesten?
Kein Modell ist perfekt, und die Ergebnisse hängen genauso von deinem Referenzbild und Prompt ab wie vom Modell. Die folgenden praktischen Rollen der VIBE-Modelle für Figurenarbeit beruhen darauf, wie jedes Modell positioniert ist und wie wir es einsetzen.
| Modell | Stufe in VIBE | Geeignet für Figurenarbeit |
|---|---|---|
| Wan 3.0 | Premium | Referenzbasierte Generierung und längere Einstellungen mit einer wiederkehrenden Figur |
| Kling 3 Pro | Premium | Multi-Shot-Sequenzen mit Schnitten zwischen Blickwinkeln |
| Seedance Pro Fast | Kostenlos | Schnelle Tests eines Figuren-Ankers, bevor du Premium nutzt |
| Wan 2.6 | Kostenlos | Image-to-Video aus einem Hero-Bild, ein solider kostenloser Einstieg |
Ein sinnvoller Ablauf: Teste Anker und Hero-Bild zuerst mit einem kostenlosen Modell. Sieht die Figur richtig aus, erzeugst du die gelungenen Einstellungen noch einmal mit einem Premium-Modell. Unser Modellvergleich geht tiefer auf die Stärken ein, und die Kling-3-Seite erklärt sein Multi-Shot-Verhalten.
Wie hältst du eine Figur über eine ganze Serie konsistent?
Behandle die Figur bei einer Serie wie eine kleine Produktions-Bibel. Notiere den Anker, die Datei des Hero-Bilds, das Modell und das Seitenverhältnis und verwende sie für jede Folge wieder. Wenn du eine Woche später zurückkehrst, willst du genau denselben Aufbau wiederholen können, statt dich auf dein Gedächtnis zu verlassen.
- Führe ein Figurenblatt. Ein Dokument mit Hero-Bild, Anker-Text und zwei oder drei freigegebenen weiteren Blickwinkeln.
- Lege das Format fest. Wähle 9:16 oder 16:9 einmal und bleibe dabei, denn ein anderer Bildausschnitt ändert auch, wie das Modell das Gesicht zeichnet.
- Variiere die Welt, nicht die Hauptfigur. Wechsle Orte und Tageszeiten, während der Anker identisch bleibt.
- Prüfe vor dem Veröffentlichen. Lege die Clips nebeneinander und kontrolliere Gesicht, Haare und Outfit, bevor du sie zusammenschneidest.
- Nutze Schnitte zu deinem Vorteil. Ein schneller Schnitt zwischen zwei kurzen Einstellungen kaschiert kleine Unterschiede deutlich besser als eine lange Einstellung.
 Kling 3 Pro
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat, stands on a ferry deck at sunrise looking at the skyline, wind moving her coat, slow push-in from medium to close-up, calm cinematic mood.”
Was zerstört die Konsistenz einer Figur, und wie behebst du es?
Die meisten Fehler entstehen durch ein paar vermeidbare Gewohnheiten. Sieht eine Figur plötzlich anders aus, geh diese Liste durch, bevor du dem Modell die Schuld gibst.
- Den Anker umformulieren. Schon kleine Änderungen verändern das Ergebnis. Kopiere und füge ein, statt neu zu tippen.
- Ein überladenes Referenzbild. Fotos mit mehreren Personen, Sonnenbrillen oder starken Schatten geben dem Modell weniger Halt. Nimm ein sauberes Porträt.
- Extreme Winkel und schnelle Bewegung. Profilansichten, Drehungen und schnelle Action sind die Stellen, an denen sich Gesichter am häufigsten verändern. Beginne mit ruhigen, frontalen Einstellungen.
- Das Modell mitten in der Serie wechseln. Jedes Modell zeichnet Gesichter anders, also beende die Serie mit einem Modell.
- Zu viel in einem Clip verlangen. Mehrere Handlungen plus Kamerafahrt plus Ortswechsel machen Abdriften wahrscheinlicher. Teile es in zwei Einstellungen auf.
Verwende nur Bilder von dir selbst, eigene Figuren oder Personen, die einer Darstellung zugestimmt haben. Konsistente Figuren sind ein kreatives Werkzeug, und es gilt dieselbe Sorgfalt wie bei jedem Porträt. Den kompletten Ablauf Schritt für Schritt in der App findest du unter So funktioniert es.
Häufig gestellte Fragen
Wie behalte ich dieselbe Figur im KI-Video?
Starte jeden Clip vom selben sauberen Referenzbild, füge in jeden Prompt eine identische Figurenbeschreibung ein, halte die Einstellungen kurz und nutze für die ganze Serie ein Modell. Image-to-Video ist der zuverlässigste Weg, weil das Bild Gesicht und Outfit festlegt.
Was ist ein Figuren-Anker in einem KI-Video-Prompt?
Ein Figuren-Anker ist eine kurze, feste Beschreibung deiner Figur mit Name, Altersspanne, Haaren, Kleidung und einem markanten Detail. Du setzt sie wortgleich an den Anfang jedes Prompts, damit das Modell weniger Spielraum zum Improvisieren hat.
Was ist Reference-to-Video bei der KI-Videogenerierung?
Reference-to-Video ist ein Modus, in dem ein Modell Referenzbilder, manchmal auch Videos oder Audio, erhält und die darin gezeigte Identität beibehält, während es neue Bewegung erzeugt. Wan 3.0 ist ein aktuelles Beispiel, laut Alibaba bleiben Gesicht, Haare, Körperform und Kleidung einer Figur konsistent.
Welches VIBE-Modell eignet sich am besten für konsistente Figuren?
Wan 3.0 ist das erste Modell, das du für referenzbasierte Konsistenz testen solltest, und Kling 3 Pro ist eine starke Wahl für Multi-Shot-Sequenzen. Seedance Pro Fast und Wan 2.6 sind kostenlos und gut, um eine Figur zu testen, bevor du Premium-Generierungen einsetzt.
Warum sieht meine KI-Figur in jedem Video anders aus?
Jede Generierung beginnt bei null, und eine vage Textbeschreibung passt auf viele Gesichter. Ohne Referenzbild und feste Beschreibung wählt das Modell jedes Mal ein neues Gesicht. Längere Clips, neues Licht und extreme Winkel verstärken das Abdriften.
Kann ich kostenlos eine konsistente Figur erstellen?
Ja. VIBE ist kostenlos startbar und braucht keinen Login, und mit den kostenlosen Modellen Seedance Pro Fast und Wan 2.6 kannst du Hero-Bild und Anker-Prompt testen. Wechsle erst für die finalen Einstellungen zu einem Premium-Modell.
Wie lang sollten Clips sein, damit eine Figur konsistent bleibt?
Kürzer ist sicherer. Wenige Sekunden pro Einstellung, mit Schnitten verbunden, driften weniger ab als eine lange Einstellung. Längere Clips sind bei manchen Modellen möglich, prüfe aber am Ende Gesicht und Outfit, bevor du sie verwendest.
Erstelle KI-Videos noch heute
Lade VIBE kostenlos für iOS und Android herunter. Kein Login erforderlich. Greife auf 10+ KI-Video-Modelle zu und erstelle Videos aus Textprompts oder Bildern.
Weiterlesen
Alle Artikel Trends & Tutorials
KI-Video-Seitenverhältnis: 9:16, 16:9 oder 1:1 für jede Plattform
Welches Format passt zu TikTok, Reels, Shorts und YouTube? Ein praktischer Leitfaden, mit Safe Zones und Prompts zum Kopieren.
Vincent Park9 Min. Lesezeit Trends & Tutorials
KI Video Trends 2026: Was sich ändert und wie du es nutzt
Ton, längere Takes, konsistente Figuren, Hochformat und Kennzeichnungspflichten verändern KI-Video in diesem Jahr. Was jeder Trend bedeutet und wie du ihn nutzt.
Vincent Park9 Min. Lesezeit