Personaje consistente video IA: cómo mantener el mismo rostro en cada clip
Un personaje consistente en video con IA significa el mismo rostro, pelo y ropa de plano en plano. Te explicamos por qué los personajes cambian y el flujo con imagen de referencia y prompt que lo evita.
Escrito por Vincent Park
Publicado el
Un personaje consistente en video con IA es la misma persona o criatura, con el mismo rostro, pelo, complexión y ropa, en cada clip que generas. Se consigue empezando cada plano desde la misma imagen de referencia, fijando al personaje en una descripción corta y repetible, y eligiendo un modelo que admita generación basada en referencias, como Wan 3.0 en VIBE. Esta guía te muestra el flujo completo, con prompts que puedes copiar y pegar.
En una frase
Un personaje consistente en video con IA es la práctica de generar varios clips en los que un mismo personaje conserva el rostro, el pelo, la figura y la ropa, anclando cada generación a la misma imagen de referencia y a la misma descripción de texto fija.
¿Qué es un personaje consistente en video con IA?
Cada modelo de video con IA genera cada clip desde cero. Si no le das algo fijo a lo que agarrarse, inventa un rostro nuevo cada vez: una heroína con chaqueta verde en el primer clip puede convertirse en otra mujer con un abrigo más claro en el segundo. El personaje consistente en video con IA es el conjunto de hábitos que elimina esa aleatoriedad: una imagen de referencia fija, una descripción de texto fija y un modelo que respete ambas.
Importa sobre todo cuando hay más de un plano: una historia corta, una mascota que aparece en todas tus publicaciones, un video explicativo con un presentador recurrente o una serie semanal en TikTok o YouTube Shorts. Para un clip suelto puedes saltarte casi todo esto. Para una serie, es la diferencia entre un canal con un rostro reconocible y un feed de clips sin relación.
¿Por qué cambian los personajes de IA de un clip a otro?
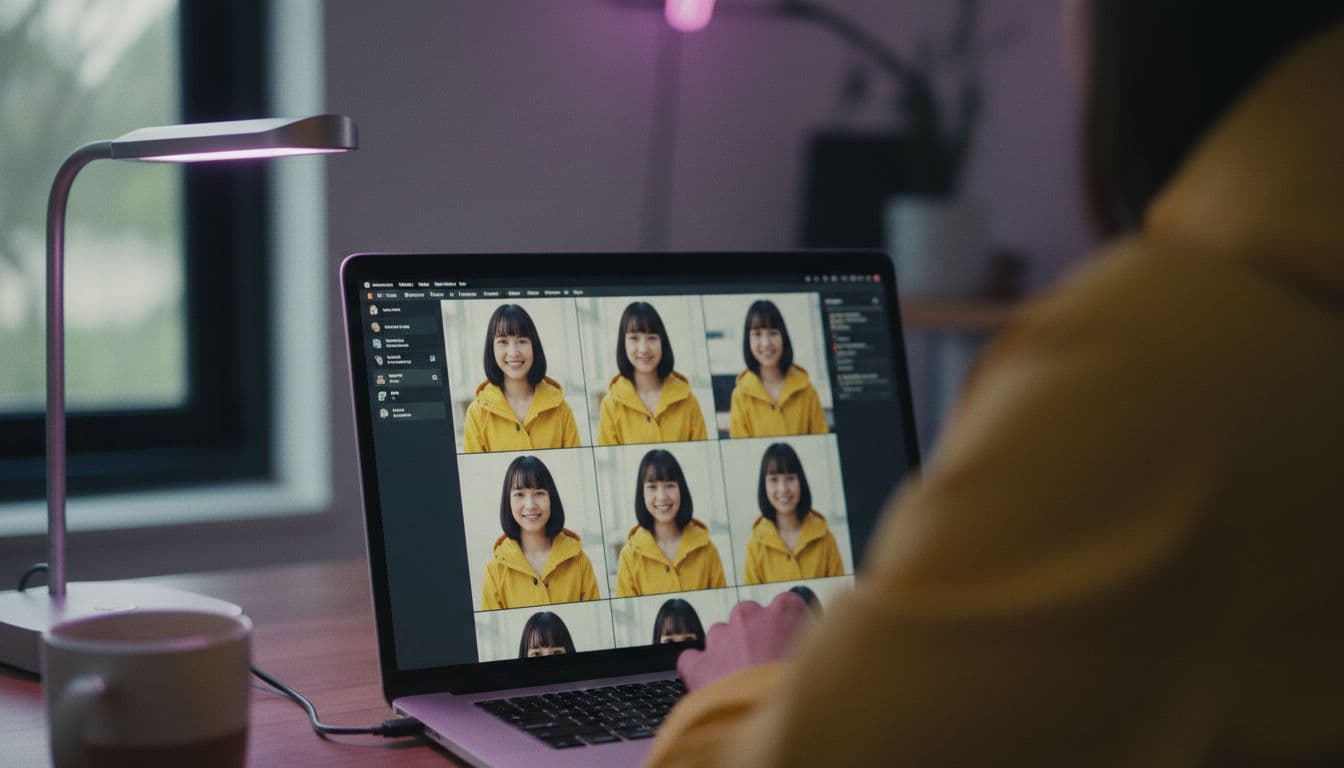
Los modelos de texto a video convierten tus palabras en píxeles mediante muestreo, y una descripción como "una joven con chaqueta verde" encaja con miles de rostros distintos. Cada nueva generación elige uno diferente. Dentro de un mismo clip corto el modelo suele mantener el rostro estable, pero entre clips no hay nada que los conecte a menos que tú pongas el vínculo.
- Descripciones vagas. "Un joven" deja al modelo libre para elegir edad, forma de la cara, pelo y tono de piel cada vez.
- Sin ancla visual. Un prompt solo de texto no da al modelo ninguna imagen que copiar, así que la identidad se reinventa en cada clip.
- Contexto cambiante. Una iluminación, un ángulo de cámara o un lugar nuevos empujan al modelo a redibujar la ropa y los detalles del rostro.
- Clips largos. Cuanto más dura una generación, más margen hay para una deriva gradual, como un peinado que cambia o un color que se desplaza.
- Modelos mezclados. Dos modelos distintos nunca dibujarán el mismo rostro a partir de la misma frase.
¿Cómo mantienes al mismo personaje en un video con IA?
El método más fiable es dejar de pedirle al modelo que invente el personaje en cada clip y entregarle, en cambio, una imagen terminada del personaje. Eso es justo lo que hace la imagen a video: la foto fija el rostro y la ropa, y el prompt solo tiene que describir el movimiento. Nuestra guía de imagen a video cubre lo básico; aquí tienes la versión centrada en personajes.
- Crea una imagen principal limpia. Funciona mejor una imagen de frente, con luz uniforme, de cintura para arriba y sobre fondo liso. Usa tu propia foto, una ilustración o una imagen que hayas generado.
- Escribe un ancla de personaje. Dos frases cortas con el rango de edad, el pelo, la ropa y un detalle distintivo. Mantenla palabra por palabra idéntica en todos los prompts.
- Genera cada plano desde la imagen principal. Empieza cada clip con la misma imagen y cambia solo la acción, la cámara y el escenario.
- Mantén cada clip corto. Apunta a unos pocos segundos por plano y corta entre ellos, en lugar de una toma larga donde la deriva pueda acumularse.
- Reutiliza el mismo modelo. Elige un modelo para la serie y quédate con él, para que el estilo de renderizado no cambie.
- Guarda tus mejores fotogramas. Si un clip termina en un gran fotograma del personaje, expórtalo y úsalo como imagen principal del siguiente plano.
 Wan 2.6
“Using the reference image: the same woman with short dark hair and a green bomber jacket walks toward the camera along a rainy city street at dusk, gentle handheld tracking shot, neon reflections on wet pavement. Keep her face, hair and jacket unchanged.”
¿Cómo escribes un ancla de personaje que no cambie?
Un ancla de personaje es un bloque de texto corto y fijo que describe a tu personaje y que se pega sin cambios al principio de cada prompt. Funciona porque le quita al modelo el margen para improvisar. Nuestra guía para escribir prompts de video con IA explica la fórmula de sujeto, acción, cámara y luz; el ancla es simplemente la parte del sujeto, congelada.
Un buen ancla es precisa en lo que el ojo nota primero y no dice nada de lo que debe cambiar entre planos. Nombra el pelo, la ropa, el rango de edad y un detalle distintivo. Deja fuera el ambiente, la acción y el lugar, que pertenecen a cada plano concreto.
 Seedance Pro Fast
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat. Mira sits at a café window and slowly turns a coffee cup in both hands, soft morning light, static medium shot, shallow depth of field.”
- Usa el mismo nombre para el personaje en todos los prompts; un nombre funciona como un asa para el modelo.
- Enumera la ropa siempre en el mismo orden: prenda superior, capa exterior, accesorios.
- Prefiere colores concretos ("impermeable amarillo mostaza") a palabras vagas ("abrigo llamativo").
- Cambia una sola cosa por plano, la acción o el lugar, nunca el personaje.
¿Qué es referencia a video y qué modelo la admite?
Referencia a video es un modo de generación en el que el modelo recibe una o varias imágenes de referencia, y a veces videos o audio, y conserva la identidad que muestran mientras crea movimiento nuevo. Va un paso más allá de la imagen a video, porque la referencia se trata como un personaje que reutilizar y no como un primer fotograma que animar. A octubre de 2026, Wan 3.0 es el ejemplo más claro: Alibaba describe su modo de referencia a video como capaz de mantener consistentes los rasgos faciales, el peinado, la complexión, la ropa y los accesorios de un personaje, además de objetos, espacios y estilo. Los detalles están en el anuncio de Wan 3.0 de Alibaba Cloud.
Las plataformas de terceros que alojan el modelo indican que acepta hasta 10 imágenes de referencia, una duración máxima de 30 segundos y salida en 1080p, y que los límites exactos dependen de dónde lo ejecutes. El modo de referencia a video es una capacidad del modelo, no una promesa sobre la interfaz de una app concreta, así que en VIBE la vía fiable hoy es una sola imagen principal sólida en imagen a video, con Wan 3.0 como el modelo que probar primero. Puedes ver todos los modelos en la lista de modelos de VIBE y leer sobre la familia WAN. (Alibaba Cloud)
¿Qué modelo de video con IA mantiene mejor la consistencia de los personajes?
Ningún modelo es perfecto, y los resultados dependen tanto de tu imagen de referencia y tu prompt como del modelo. Estos son los papeles prácticos de los modelos de VIBE para trabajar con personajes, según cómo se posiciona cada uno y cómo los usamos nosotros.
| Modelo | Nivel en VIBE | Útil para trabajar con personajes |
|---|---|---|
| Wan 3.0 | Premium | Generación basada en referencias y planos más largos con un personaje recurrente |
| Kling 3 Pro | Premium | Secuencias de varios planos en las que quieres cortes entre ángulos |
| Seedance Pro Fast | Gratis | Pruebas rápidas de un ancla de personaje antes de gastar en premium |
| Wan 2.6 | Gratis | Imagen a video desde una imagen principal, un punto de partida gratuito sólido |
Un flujo sensato es probar primero tu ancla y tu imagen principal en un modelo gratuito. Cuando el personaje se vea bien, vuelve a generar los planos que te gusten en un modelo premium. Nuestra comparativa de modelos profundiza en los puntos fuertes, y la página de Kling 3 explica su comportamiento multiplano.
¿Cómo mantienes la consistencia de un personaje a lo largo de toda una serie?
En una serie, trata al personaje como una pequeña biblia de producción. Anota el ancla, el archivo de la imagen principal, el modelo y la relación de aspecto, y reutilízalos en cada episodio. Cuando vuelvas una semana después, querrás poder repetir la configuración exacta en lugar de fiarte de la memoria.
- Mantén una hoja de personaje. Un documento con la imagen principal, el texto del ancla y dos o tres ángulos adicionales aprobados.
- Fija el formato. Elige 9:16 o 16:9 una vez y no lo cambies, porque un cambio de encuadre también cambia cómo el modelo dibuja el rostro.
- Varía el mundo, no al protagonista. Muévete entre lugares y momentos del día mientras el ancla permanece idéntica.
- Revisa antes de publicar. Coloca los clips uno al lado del otro y comprueba rostro, pelo y ropa antes de montarlos.
- Aprovecha los cortes. Un corte rápido entre dos planos cortos disimula las pequeñas diferencias mucho mejor que una sola toma larga.
 Kling 3 Pro
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat, stands on a ferry deck at sunrise looking at the skyline, wind moving her coat, slow push-in from medium to close-up, calm cinematic mood.”
¿Qué rompe la consistencia del personaje y cómo se arregla?
La mayoría de los fallos vienen de unos pocos hábitos evitables. Si de pronto un personaje se ve distinto, repasa esta lista antes de culpar al modelo.
- Reescribir el ancla. Hasta los cambios pequeños alteran el resultado. Copia y pega en lugar de volver a teclear.
- Una imagen de referencia recargada. Las fotos con varias personas, gafas de sol o sombras fuertes dan menos a lo que agarrarse al modelo. Usa un retrato limpio.
- Ángulos extremos y movimiento rápido. Los perfiles, los giros y la acción rápida son donde más a menudo cambian los rostros. Empieza con planos tranquilos y de frente.
- Cambiar de modelo a mitad de serie. Cada modelo dibuja los rostros de forma distinta, así que termina la serie con un solo modelo.
- Pedir demasiado en un clip. Varias acciones más un movimiento de cámara más un cambio de lugar hacen más probable la deriva. Divídelo en dos planos.
Usa solo imágenes tuyas, personajes originales o personas que hayan aceptado aparecer. Los personajes consistentes son una herramienta creativa, y se aplica el mismo cuidado que tendrías con cualquier retrato. Para ver el flujo completo paso a paso dentro de la app, consulta cómo funciona.
Preguntas frecuentes
¿Cómo mantengo al mismo personaje en un video con IA?
Empieza cada clip desde la misma imagen de referencia limpia, pega una descripción de personaje idéntica en cada prompt, mantén los planos cortos y usa un solo modelo para toda la serie. La imagen a video es la vía más fiable porque la imagen fija el rostro y la ropa.
¿Qué es un ancla de personaje en un prompt de video con IA?
Un ancla de personaje es una descripción corta y fija de tu personaje, con nombre, rango de edad, pelo, ropa y un detalle distintivo, que se pega palabra por palabra al principio de cada prompt para que el modelo tenga menos margen para improvisar.
¿Qué es la referencia a video en la generación de video con IA?
Referencia a video es un modo en el que el modelo recibe imágenes de referencia, y a veces videos o audio, y conserva la identidad que muestran mientras genera movimiento nuevo. Wan 3.0 es un ejemplo actual, y Alibaba afirma que mantiene consistentes el rostro, el pelo, la complexión y la ropa de un personaje.
¿Qué modelo de VIBE es mejor para personajes consistentes?
Wan 3.0 es el primer modelo que probar para lograr consistencia basada en referencias, y Kling 3 Pro es una gran opción para secuencias de varios planos. Seedance Pro Fast y Wan 2.6 son gratuitos y sirven para probar un personaje antes de usar generaciones premium.
¿Por qué mi personaje de IA se ve distinto en cada video?
Cada generación parte de cero, y una descripción de texto vaga encaja con muchos rostros. Sin una imagen de referencia ni una descripción fija, el modelo elige un rostro nuevo cada vez. Los clips largos, la iluminación nueva y los ángulos extremos añaden más deriva.
¿Puedo crear un personaje consistente gratis?
Sí. VIBE es gratis para empezar y sin registro, y los modelos gratuitos Seedance Pro Fast y Wan 2.6 te permiten probar una imagen principal y un prompt de ancla. Pasa a un modelo premium solo para los planos finales.
¿Qué duración deben tener los clips para mantener la consistencia de un personaje?
Cuanto más cortos, más seguro. Unos pocos segundos por plano, unidos con cortes, derivan menos que una sola toma larga. En algunos modelos son posibles clips más largos, pero revisa el rostro y la ropa al final antes de usarlos.
- #consistentcharacteraivideo
- #aivideocharacterconsistency
- #referencetovideo
- #wan3.0
Empieza a Crear Videos IA Hoy
Descarga VIBE gratis en iOS y Android. Sin necesidad de iniciar sesión. Accede a más de 10 modelos de video IA y genera videos a partir de prompts de texto o imágenes.
Sigue leyendo
Todos los artículos Tendencias y tutoriales
Relación de aspecto del vídeo IA: 9:16, 16:9 o 1:1 para cada plataforma
¿Qué formato encaja con TikTok, Reels, Shorts y YouTube? Una guía práctica para elegir la proporción antes de generar, con zonas seguras y prompts para copiar.
Vincent Park9 min de lectura Tendencias y tutoriales
Tendencias de video con IA 2026: qué cambia y cómo aprovecharlo
Sonido, tomas más largas, personajes consistentes, formato vertical y reglas de transparencia están cambiando el video con IA este año. Qué significa cada cambio y cómo usarlo.
Vincent Park9 min de lectura