דמות עקבית בוידאו AI: איך שומרים על אותו פרצוף בכל קליפ
דמות עקבית בוידאו AI פירושה אותו פרצוף, אותו שיער ואותו לבוש מצילום לצילום. הנה הסיבה לכך שדמויות משתנות, ותהליך העבודה עם תמונת ייחוס ופרומפט שעוצר את זה.
נכתב על ידי Vincent Park
פורסם
דמות עקבית בוידאו AI פירושה אותו אדם או יצור, עם אותו פרצוף, שיער, מבנה גוף ולבוש, בכל קליפ שאתם מייצרים. משיגים אותה כשמתחילים כל צילום מאותה תמונת ייחוס, נועלים את הדמות בתיאור קצר שחוזר על עצמו, ובוחרים מודל שתומך ביצירה מבוססת ייחוס, כמו Wan 3.0 ב-VIBE. המדריך הזה מציג את תהליך העבודה המלא, עם פרומפטים שאפשר להעתיק.
במשפט אחד
דמות עקבית בוידאו AI היא שיטת עבודה שבה מייצרים כמה קליפים ובכולם הדמות שומרת על אותו פרצוף, שיער, מבנה גוף ולבוש, בזכות עיגון כל יצירה לאותה תמונת ייחוס ולאותו תיאור טקסט קבוע.
מהי דמות עקבית בוידאו AI?
כל מודל וידאו מבוסס AI מייצר כל קליפ מאפס. אם לא נותנים לו משהו קבוע להיאחז בו, הוא ממציא פרצוף חדש בכל פעם, ולכן גיבורה שהיא אישה במעיל ירוק בקליפ הראשון עלולה להפוך לאישה אחרת במעיל בהיר יותר בקליפ השני. דמות עקבית בוידאו AI היא אוסף של הרגלים שמסלקים את האקראיות הזו: תמונת ייחוס קבועה, תיאור טקסט קבוע ומודל שמכבד את שניהם.
זה חשוב במיוחד בכל דבר שיש בו יותר מצילום אחד: סיפור קצר, קמע מותג שמופיע בכל פוסט, סרטון הסבר למוצר עם מגיש קבוע, או סדרה שבועית ב-TikTok או ב-YouTube Shorts. בקליפ בודד אפשר לדלג על רוב השלבים. בסדרה זה ההבדל בין ערוץ עם פנים מוכרות לבין פיד של קליפים שאין ביניהם קשר.
למה דמויות AI משתנות מקליפ לקליפ?
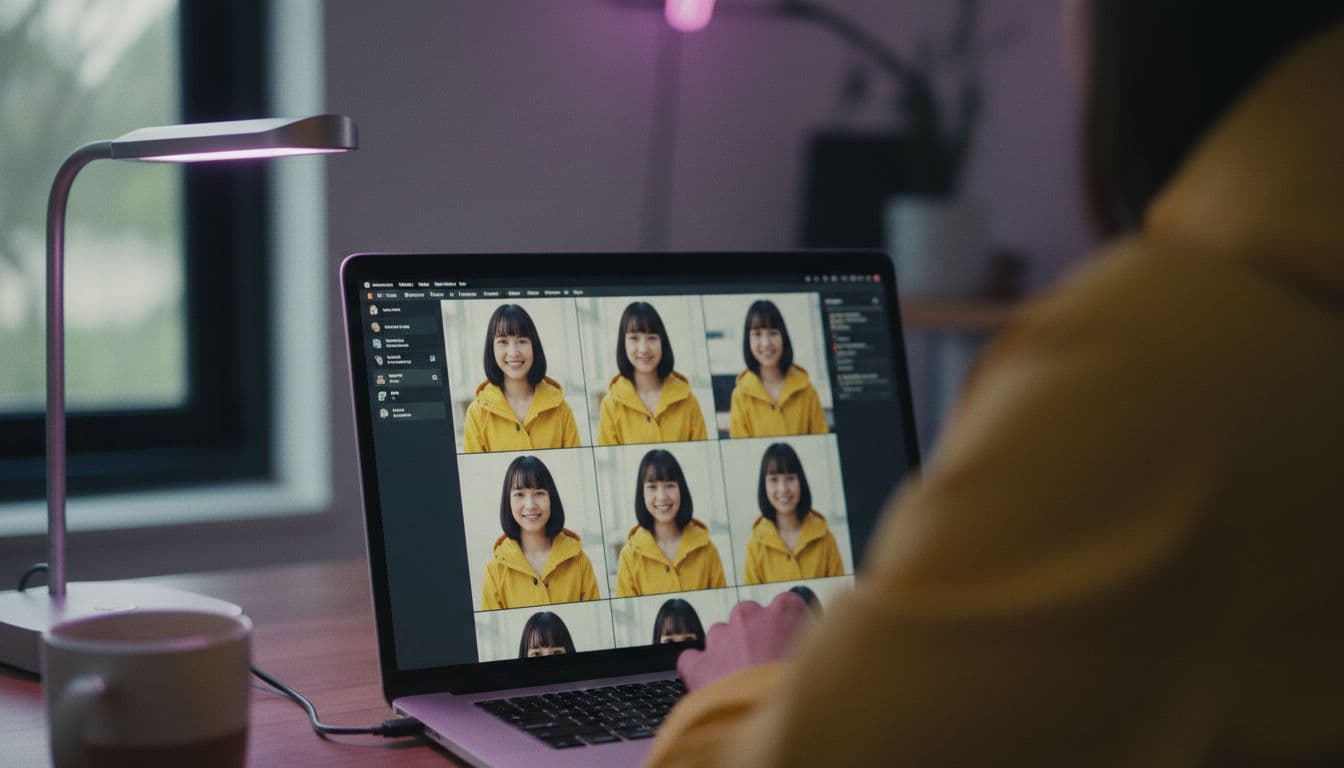
מודלים של טקסט לוידאו הופכים מילים לפיקסלים באמצעות דגימה, ותיאור כמו “אישה צעירה במעיל ירוק” מתאים לאלפי פרצופים שונים. כל יצירה חדשה בוחרת פרצוף אחר. בתוך קליפ קצר אחד המודל בדרך כלל מצליח להחזיק פרצוף יציב, אבל בין קליפים אין שום דבר שמחבר ביניהם, אלא אם אתם יוצרים את הקשר.
- תיאורים עמומים. “גבר צעיר” משאיר למודל חופש לבחור בכל פעם גיל, מבנה פנים, שיער וגוון עור.
- אין עוגן ויזואלי. פרומפט טקסט בלבד לא נותן למודל תמונה להעתיק, ולכן הזהות מומצאת מחדש בכל קליפ.
- הקשר משתנה. תאורה חדשה, זווית מצלמה חדשה או מיקום חדש גורמים למודל לצייר מחדש את הלבוש ופרטי הפנים.
- קליפים ארוכים. ככל שיצירה אחת נמשכת זמן רב יותר, יש יותר מקום לסחף הדרגתי, כמו תסרוקת שמשתנה או גוון שמחליף צבע.
- ערבוב מודלים. שני מודלים שונים לעולם לא יציירו את אותו פרצוף מאותו משפט.
איך שומרים על אותה דמות בוידאו AI?
השיטה האמינה ביותר היא להפסיק לבקש מהמודל להמציא את הדמות בכל קליפ, ובמקום זאת למסור לו תמונה מוגמרת שלה. תמונה לוידאו עושה בדיוק את זה: התמונה קובעת את הפנים והלבוש, והפרומפט צריך לתאר רק תנועה. המדריך שלנו לתמונה לוידאו מכסה את היסודות, וכאן מופיעה הגרסה המותאמת לדמויות.
- צרו תמונת גיבור אחת ונקייה. תמונה חזיתית, מוארת בצורה אחידה, מהמותניים ומעלה, של הדמות על רקע פשוט, עובדת הכי טוב. אפשר להשתמש בתמונה שלכם, באיור או בתמונה שייצרתם.
- כתבו עוגן לדמות. שני משפטים קצרים שמציינים טווח גילאים, שיער, לבוש ופרט ייחודי אחד. השאירו אותו זהה מילה במילה בכל פרומפט.
- ייצרו כל צילום מתמונת הגיבור. התחילו כל קליפ מאותה תמונה ושנו רק את הפעולה, המצלמה והסביבה.
- שמרו על קליפים קצרים. כוונו לכמה שניות לצילום וחברו ביניהם בחיתוכים, במקום לצילום ארוך אחד שבו סחף יכול להצטבר.
- השתמשו באותו מודל. בחרו מודל אחד לסדרה והישארו איתו, כדי שסגנון הרינדור לא יזוז.
- שמרו את הפריימים הטובים ביותר. אם קליפ מסתיים בפריים מצוין של הדמות, ייצאו אותו והשתמשו בו כתמונת הגיבור של הצילום הבא.
 Wan 2.6
“Using the reference image: the same woman with short dark hair and a green bomber jacket walks toward the camera along a rainy city street at dusk, gentle handheld tracking shot, neon reflections on wet pavement. Keep her face, hair and jacket unchanged.”
איך כותבים עוגן לדמות שנשאר זהה?
עוגן לדמות הוא קטע טקסט קצר וקבוע שמתאר את הדמות שלכם, ומודבק ללא שינוי בתחילת כל פרומפט. הוא עובד כי הוא מסיר מהמודל את המרחב לאלתר. המדריך שלנו על כתיבת פרומפטים לוידאו AI מסביר את נוסחת הנושא, הפעולה, המצלמה והאור; העוגן הוא פשוט חלק הנושא, מוקפא.
עוגן טוב מדויק לגבי הדברים שהעין קולטת ראשונים, ושותק לגבי כל מה שאמור להשתנות בין צילומים. ציינו את השיער, הלבוש, טווח הגילאים ופרט ייחודי אחד. השמיטו מצב רוח, פעולה ומיקום, ששייכים לצילום הבודד.
 Seedance Pro Fast
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat. Mira sits at a café window and slowly turns a coffee cup in both hands, soft morning light, static medium shot, shallow depth of field.”
- השתמשו באותו שם לדמות בכל פרומפט; שם משמש למודל כידית אחיזה.
- פרטו את הלבוש באותו סדר בכל פעם: חלק עליון, שכבה חיצונית, אביזרים.
- העדיפו צבעים מוחשיים (“מעיל גשם בצבע חרדל”) על פני מילים עמומות (“מעיל בהיר”).
- שנו דבר אחד בלבד בכל צילום, או את הפעולה או את המיקום, אף פעם לא את הדמות.
מהו ייחוס לוידאו, ואיזה מודל תומך בו?
ייחוס לוידאו (reference-to-video) הוא מצב יצירה שבו המודל מקבל תמונת ייחוס אחת או יותר, ולעיתים גם וידאו או אודיו, ושומר על הזהות שמופיעה בהן בזמן שהוא יוצר תנועה חדשה. זה צעד מעבר לתמונה לוידאו, כי הייחוס נחשב לדמות לשימוש חוזר ולא לפריים ראשון להנפשה. נכון לאוקטובר 2026, Wan 3.0 היא הדוגמה הברורה ביותר: עלי באבא מתארת את מצב הייחוס לוידאו שלה כמצב ששומר על עקביות של תווי הפנים, התסרוקת, מבנה הגוף, הלבוש והאביזרים של הדמות, וכן של אביזרי במה, מרחבים וסגנון. הפרטים נמצאים בהכרזה של Alibaba Cloud על Wan 3.0.
פלטפורמות צד שלישי שמארחות את המודל מדווחות שהוא מקבל עד 10 תמונות ייחוס, אורך מרבי של 30 שניות ופלט ב-1080p, ושהמגבלות המדויקות תלויות במקום שבו מריצים אותו. מצב הייחוס לוידאו הוא יכולת של המודל, לא הבטחה לגבי הממשק של אפליקציה כלשהי, ולכן ב-VIBE הדרך האמינה כיום היא תמונת גיבור חזקה אחת בתמונה לוידאו, עם Wan 3.0 כמודל הראשון לנסות. את כל המודלים אפשר לראות ברשימת המודלים של VIBE, ואפשר לקרוא על משפחת WAN. (Alibaba Cloud)
איזה מודל וידאו AI שומר על דמויות בצורה העקבית ביותר?
אף מודל אינו מושלם, והתוצאות תלויות בתמונת הייחוס ובפרומפט לא פחות מאשר במודל. אלה התפקידים המעשיים של מודלי VIBE בעבודה עם דמויות, על סמך האופן שבו כל אחד מהם ממוצב ושבו אנחנו משתמשים בו.
| מודל | רמה ב-VIBE | מתאים לעבודה עם דמויות |
|---|---|---|
| Wan 3.0 | פרימיום | יצירה מבוססת ייחוס וצילומים ארוכים יותר עם דמות חוזרת אחת |
| Kling 3 Pro | פרימיום | רצפים מרובי צילומים שבהם רוצים חיתוכים בין זוויות |
| Seedance Pro Fast | חינמי | בדיקות מהירות של עוגן דמות לפני שמשקיעים בפרימיום |
| Wan 2.6 | חינמי | תמונה לוידאו מתמונת גיבור, נקודת פתיחה חינמית וטובה |
תהליך עבודה הגיוני הוא לבדוק את העוגן ואת תמונת הגיבור קודם במודל חינמי. כשהדמות נראית נכון, מייצרים מחדש את הצילומים הטובים במודל פרימיום. השוואת המודלים שלנו מעמיקה בחוזקות של כל אחד, ועמוד Kling 3 מסביר את ההתנהגות שלו בריבוי צילומים.
איך שומרים על עקביות של דמות לאורך סדרה שלמה?
בסדרה, התייחסו לדמות כאל ספר הפקה קטן. רשמו את העוגן, את קובץ תמונת הגיבור, את המודל ואת יחס התמונה, והשתמשו בהם מחדש בכל פרק. כשאתם חוזרים כעבור שבוע, כדאי שתוכלו לשחזר את ההגדרה המדויקת ולא להסתמך על הזיכרון.
- נהלו דף דמות. מסמך אחד עם תמונת הגיבור, טקסט העוגן ושתיים או שלוש זוויות נוספות שאושרו.
- נעלו את הפורמט. בחרו 9:16 או 16:9 פעם אחת והישארו איתו, כי שינוי בפריים משנה גם את האופן שבו המודל מצייר את הפנים.
- שנו את העולם, לא את הגיבור. עברו בין מיקומים ושעות ביום בזמן שהעוגן נשאר זהה.
- בדקו לפני פרסום. הציבו את הקליפים זה לצד זה ובדקו פנים, שיער ולבוש לפני שאתם עורכים אותם יחד.
- נצלו את החיתוכים. חיתוך מהיר בין שני צילומים קצרים מסתיר הבדלים קטנים הרבה יותר טוב מצילום ארוך אחד.
 Kling 3 Pro
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat, stands on a ferry deck at sunrise looking at the skyline, wind moving her coat, slow push-in from medium to close-up, calm cinematic mood.”
מה שובר את העקביות של הדמות, ואיך מתקנים?
רוב הכשלים נובעים ממספר קטן של הרגלים שאפשר להימנע מהם. אם דמות נראית פתאום אחרת, עברו על הרשימה הזו לפני שאתם מאשימים את המודל.
- ניסוח מחדש של העוגן. גם עריכות קטנות משנות את התוצאה. העתיקו והדביקו במקום להקליד מחדש.
- תמונת ייחוס עמוסה. תמונות עם כמה אנשים, משקפי שמש או צללים כבדים נותנות למודל פחות על מה להישען. השתמשו בדיוקן נקי.
- זוויות קיצוניות ותנועה מהירה. פרופיל, סיבובים ופעולה מהירה הם המקומות שבהם פנים משתנות לרוב. התחילו בצילומים רגועים וחזיתיים.
- החלפת מודלים באמצע סדרה. כל מודל מצייר פנים אחרת, ולכן סיימו את הסדרה במודל אחד.
- בקשה להרבה מדי בקליפ אחד. כמה פעולות יחד עם תנועת מצלמה ושינוי מיקום מגדילים את הסיכוי לסחף. פצלו לשני צילומים.
השתמשו רק בתמונות של עצמכם, בדמויות מקוריות או באנשים שהסכימו להופיע. דמויות עקביות הן כלי יצירתי, ואותה זהירות שהייתם נוהגים בה בכל דיוקן חלה גם כאן. לתהליך המלא צעד אחר צעד בתוך האפליקציה, ראו איך זה עובד.
שאלות נפוצות
איך שומרים על אותה דמות בוידאו AI?
התחילו כל קליפ מאותה תמונת ייחוס נקייה, הדביקו תיאור דמות זהה בכל פרומפט, שמרו על צילומים קצרים והשתמשו במודל אחד לכל הסדרה. תמונה לוידאו היא הדרך האמינה ביותר, כי התמונה קובעת את הפנים והלבוש.
מהו עוגן דמות בפרומפט לוידאו AI?
עוגן דמות הוא תיאור קצר וקבוע של הדמות שלכם, הכולל שם, טווח גילאים, שיער, לבוש ופרט ייחודי אחד, ומודבק מילה במילה בתחילת כל פרומפט, כך שלמודל יש פחות מקום לאלתר.
מהו ייחוס לוידאו ביצירת וידאו AI?
ייחוס לוידאו הוא מצב שבו המודל מקבל תמונות ייחוס, ולעיתים גם וידאו או אודיו, ושומר על הזהות שמופיעה בהן בזמן יצירת תנועה חדשה. Wan 3.0 היא דוגמה עדכנית, ועלי באבא מציינת שהיא שומרת על עקביות הפנים, השיער, מבנה הגוף והלבוש של הדמות.
איזה מודל ב-VIBE הכי מתאים לדמויות עקביות?
Wan 3.0 הוא המודל הראשון לנסות לעקביות מבוססת ייחוס, ו-Kling 3 Pro הוא בחירה חזקה לרצפים מרובי צילומים. Seedance Pro Fast ו-Wan 2.6 חינמיים ומתאימים לבדיקת דמות לפני שמשתמשים ביצירות פרימיום.
למה דמות ה-AI שלי נראית אחרת בכל סרטון?
כל יצירה מתחילה מאפס, ותיאור טקסט עמום מתאים להרבה פנים. בלי תמונת ייחוס ותיאור קבוע, המודל בוחר פרצוף חדש בכל פעם. קליפים ארוכים, תאורה חדשה וזוויות קיצוניות מוסיפים עוד סחף.
אפשר ליצור דמות עקבית בחינם?
כן. אפשר להתחיל ב-VIBE בחינם וללא התחברות, והמודלים החינמיים Seedance Pro Fast ו-Wan 2.6 מאפשרים לבדוק תמונת גיבור ופרומפט עוגן. שדרגו למודל פרימיום רק לצילומים הסופיים.
כמה זמן צריכים להיות הקליפים כדי לשמור על דמות עקבית?
קצר בטוח יותר. כמה שניות לצילום, מחוברות בחיתוכים, סוחפות פחות מצילום ארוך אחד. קליפים ארוכים יותר אפשריים בחלק מהמודלים, אבל בדקו את הפנים והלבוש בסוף לפני שאתם משתמשים בהם.
התחילו ליצור סרטוני AI היום
הורידו את VIBE בחינם ל-iOS ו-Android. ללא צורך בהתחברות. גישה ל-10+ מודלי וידאו AI ויצירת סרטונים מפרומפטי טקסט או מתמונות.
להמשך קריאה
כל המאמרים טרנדים והדרכות
יחס גובה-רוחב בווידאו AI: 9:16, 16:9 או 1:1 לכל פלטפורמה
איזה פורמט מתאים לטיקטוק, ריליז, שורטס ויוטיוב? מדריך מעשי לבחירת היחס לפני היצירה, עם אזורים בטוחים ופרומפטים להעתקה.
Vincent Park9 דק׳ קריאה טרנדים והדרכות
טרנדים בווידאו AI 2026: מה משתנה ואיך משתמשים בזה
סאונד, טייקים ארוכים יותר, דמויות עקביות, פורמט אנכי וכללי גילוי משנים את הווידאו AI השנה. מה כל מגמה אומרת ואיך משתמשים בה.
Vincent Park9 דק׳ קריאה