AI動画トレンド2026:何が変わり、どう活用するか
音声、長尺テイク、一貫したキャラクター、縦型、開示ルールが今年のAI動画を変えています。各トレンドの意味と使い方を紹介します。
執筆 Vincent Park
公開日
AI動画トレンド2026の大きな流れは、ネイティブ音声、長めのワンテイク、参照によるキャラクターの一貫性、縦型ファースト、そしてAIコンテンツの明確な表示です。2026年10月時点で、そのほとんどをVIBEで使えます。このガイドでは、各トレンドがクリップにとって何を意味するのかを、すぐ試せるプロンプトとともに説明します。
ひとことで言うと
AI動画トレンド2026とは、今年のAI動画モデルとプラットフォームの動き方の変化のことです。映像と同時に生成される音声、数秒以上続くクリップ、キャラクターを一貫させる参照入力、9:16を前提としたフォーマット、AI制作コンテンツの開示ルールを指します。
2026年のAI動画の最大のトレンドは何ですか?
目立つ変化は5つあり、いずれもここ数か月のモデル発表で確認できるもので、憶測ではありません。モデルは映像と一緒に音声を生成し、1本のクリップは長くなり、参照入力でキャラクターを再現でき、縦型動画は後回しではなく標準になり、プラットフォームはAIコンテンツの表示を厳しくしています。まず基本から知りたい場合は、これらすべてのトレンドの土台となる文の組み立て方を扱ったAI動画プロンプトの書き方ガイドをご覧ください。
- ネイティブ音声:セリフ、効果音、環境音が映像と同じレンダリングで届きます。
- 長めのテイク:8秒から、発表によれば最大30秒までのクリップが、シーンの組み立て方を変えます。
- 参照による一貫性:写真、モデルによっては動画や音声が、画面に登場する人物や物を決めます。
- 縦型ファースト:9:16は後から切り抜くものではなく、モデルがそれを前提に構図を作る標準フォーマットです。
- 開示とラベル:プラットフォームは、リアルなコンテンツがAI制作であることの明示をますます求めています。
ネイティブ音声はAI動画の標準になりましたか?
ハイエンドでは標準になりつつありますが、まだ普遍的ではありません。Google DeepMindは、Veo 3.1が効果音、環境音、セリフを追加でき、すべての音声をネイティブに生成すると述べています。またAlibabaのWan 3.0発表は、このモデルがネイティブの音声・動画生成に対応するとしています。
VIBEでの状況はより具体的です。2026年10月時点で、Veo 3.1 FastとKling 3 Proは動画と一緒に音声を生成し、Wan 3.0を含むVIBEのその他のモデルは映像のみを生成します。2つの詳しい比較は音声付きAI動画ガイドにあります。実践のコツは、カメラやライトを書くのと同じように、音のこともプロンプトに書くこと。誰が話し、何を言うのかまで指定しましょう。
 Veo 3.1 Fast
“A street musician plays violin on a rainy corner at dusk, a passer-by says "Beautiful tune" and drops a coin in the case, close-up of the bow, warm shop light, rain on the pavement, soft violin music and rain ambience, vertical 9:16”
2026年のAI動画クリップはどのくらいの長さにできますか?
クリップの長さはモデルによって大きく異なるため、それを前提に計画する価値があります。Googleは、Veoのクリップは8秒で、シーン延長で伸ばせると説明しています。VIBEのKling 3 Proは15秒に対応し、AlibabaはWan 3.0が最大1080pで最長30秒の動画を生成できるとしています。下の表で3つを比較します。
| モデル | 開発元 | クリップの長さ | VIBEでの音声 |
|---|---|---|---|
| Veo 3.1 Fast | Google DeepMind | 8秒 | あり(ネイティブ) |
| Kling 3 Pro | Kuaishou | 最大15秒 | あり(ネイティブ) |
| Wan 3.0 | Alibaba | 最大30秒(Alibaba発表) | 映像のみ |
長いテイクが自動的に良いわけではありません。モデルが埋める秒数が増えるほど、内容がずれやすくなります。1クリップにつき1つの連続した動作を書き、物語はカメラに任せましょう。複数の見せ場がほしい場合は、複数のクリップを生成してつなぎます。Wanモデルのページでこのモデルファミリーの動きの扱いを確認できます。表のどのモデルにも「1動作ルール」は当てはまります。
参照画像はどのようにキャラクターの一貫性を保ちますか?
参照入力を使えば、キャラクターや物をゼロから言葉で説明する代わりに、見た目をモデルに見せられます。DeepMindは、Veo 3.1がキャラクター、スタイル、物の参照画像を受け付けると述べ、Alibabaは、Wan 3.0が最大10枚の画像、5本の動画、5つの音声を参照として組み合わせられるとしています。VIBEで現時点で最も確実なのは画像から動画への方法です。写真から動画へのガイドで説明しているように、顔、服装、背景を固定する1枚の写真から始めます。
- 被写体がはっきりして明るく写っているメイン画像を1枚選び、すべてのクリップの開始フレームとして使います。
- 服装や髪型などキャラクターの説明を毎回のプロンプトで完全に同じにし、変えるのは動作だけにします。
- 1クリップにつき動作は1つにして、モデルがキャラクターについて余計なことを作り出さないようにします。
- レンズ、光、色調など、同じスタイルの言葉をすべてのプロンプトで繰り返します。
 Kling 3 Pro
“Using the uploaded photo as the first frame: the woman in the green raincoat turns toward the camera and smiles, then walks forward along the same market street, handheld camera at eye level, natural overcast light, same outfit and hairstyle throughout”
なぜ縦型9:16がいまの標準フォーマットなのですか?
AI動画の多くはスマートフォンでTikTok、Instagramリール、YouTubeショートとして視聴されるため、モデルやアプリは9:16を第一級のフォーマットとして扱うようになりました。DeepMindは縦型9:16出力をVeo 3.1の機能として挙げており、横長の画面を切り抜くのではなく、縦長のフレームを前提に構図を作ることを意味します。切り抜きでは被写体や想定した動きが切れてしまうことがあるため、ネイティブな構図が重要です。
- 被写体はフレームの中央3分の1に置き、アプリのボタンやキャプションが重なる端を避けます。
- 被写体は1つに絞り、背景はシンプルに。スマートフォンの画面では細部は見えなくなります。
- 上へのチルトや、カメラに向かって歩く被写体など、縦方向の動きを書いて、フレームの高さを活かします。
- 生成前に9:16を選び、あとから切り抜かないようにします。
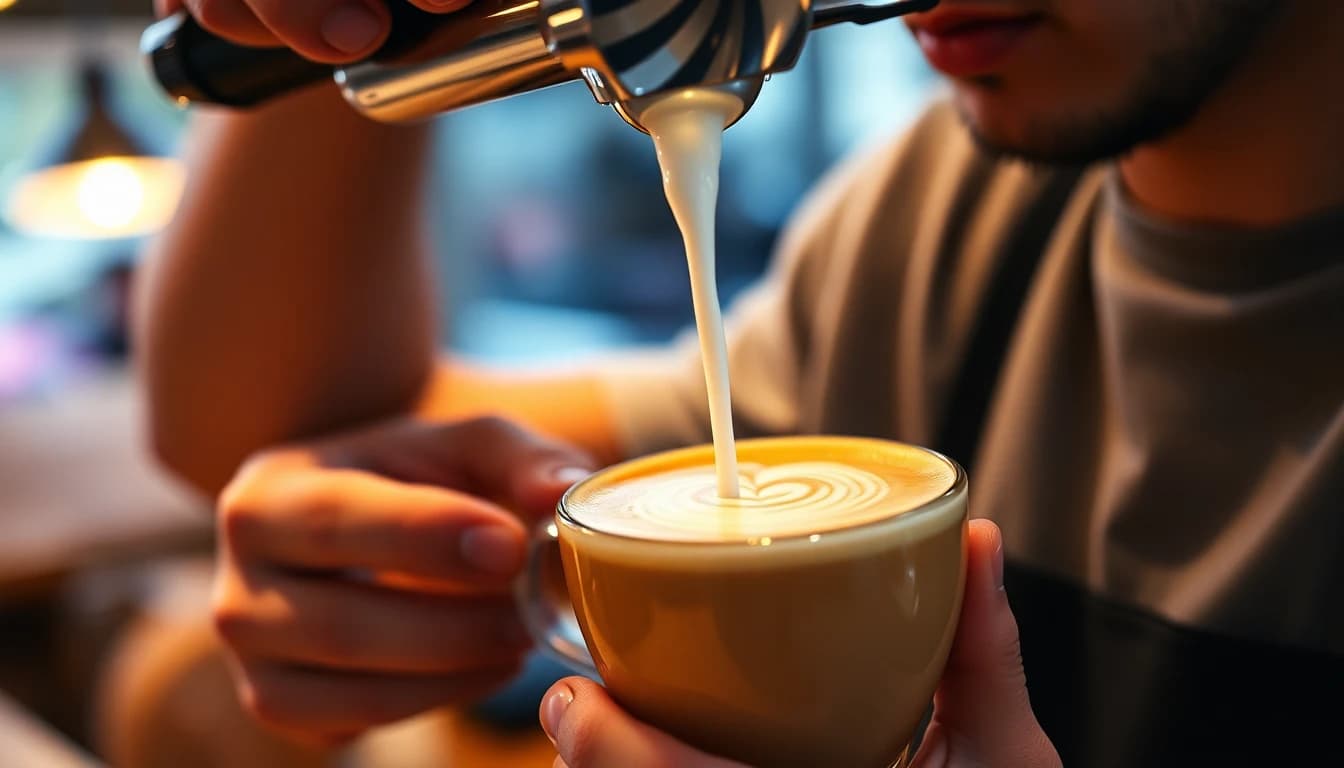
 Seedance Pro Fast
“Close-up of a barista pouring steamed milk into a latte, latte art forming, slow tilt up from the cup to a smiling face, warm cafe light, shallow depth of field, vertical 9:16”
Soraに何が起きたのか、なぜ重要なのですか?
OpenAIは、ヘルプセンターの説明のとおり、Soraの一般提供を終了しました。経緯と代替手段はSora 2の解説記事で扱っています。クリエイターへの教訓は、どのモデルも永続的ではないということです。プロンプトは他のモデルでも使えるようにしておき、お気に入りは保存し、複数のモデルを使えるアプリを選べば、モデルの変更や終了でワークフローが止まることはありません。VIBEは無料モデルを含む複数のモデルを1つのアプリで提供しています。
2026年にAI動画へラベルを付ける必要はありますか?
YouTubeでは、リアルなコンテンツであれば必要です。YouTubeのポリシーは、リアルに見える大幅に加工された、または合成されたコンテンツを開示するよう求めており、実写に近いコンテンツはプレーヤー内に、アニメや明らかに非現実的なコンテンツは説明欄にラベルが表示されます。YouTubeは、開示しても視聴リーチや収益化は制限されないとしていますが、繰り返し開示しない場合は、YouTubeによるラベル付与、削除、パートナープログラムの停止もあり得ます。ルールはプラットフォームごとに異なり頻繁に変わるため、投稿前に最新のヘルプページを確認してください。
- 実際の出来事や実在の人物と誤解されかねないリアルなAIシーンは開示しましょう。
- 実在の人物が言っていないこと、していないことをしているように見せるためにAIを使ってはいけません。
- 視聴者が気づくことを期待せず、アップロード時のAI設定を使いましょう。
これらのトレンドを今日VIBEでどう使えますか?
- iOS、Android、ウェブでVIBEを開き、Seedance Pro Fastなどの無料モデルから始めます。試すのにログインは不要です。
- 1クリップにつき1動作を書き、ショート動画向けにフォーマットを9:16に設定します。
- セリフや音声が欲しいときはVeo 3.1 FastかKling 3 Pro、より長いテイクが欲しいときはWan 3.0に切り替えます。
- リアルなクリップはアップロード時にラベルを付け、お気に入りのプロンプトは再利用のために保存します。
モデルの全一覧と無料モデルはVIBEのモデルセクションで確認でき、下のプロンプトで長めのテイクを試せます。
 Wan 3.0
“One continuous shot following a hiker along a ridge trail at sunrise, the camera drifts slowly beside them as mist lifts from the valley, steady pace, soft golden light, natural motion, no cuts”
よくある質問
2026年の主なAI動画トレンドは何ですか?
AI動画トレンド2026の主なものは、ネイティブ音声、長めの単一クリップ、参照による一貫性、縦型9:16出力、AIコンテンツのより明確な開示です。2026年10月時点で、Veo 3.1、Kling 3 Pro、Wan 3.0などのモデルがこれらの複数を同時に備えています。
自動で音声を生成するAI動画モデルはどれですか?
VIBEでは、Google DeepMindのVeo 3.1 FastとKuaishouのKling 3 Proが動画と一緒に音声を生成します。無料モデルを含むVIBEのその他のモデルは現在映像のみなので、音楽やナレーションは後から追加します。
2026年のAI動画はどのくらいの長さにできますか?
モデルによって異なります。Veo 3.1 Fastは8秒、Kling 3 Proは最大15秒、AlibabaはWan 3.0が最大30秒を生成できるとしています。長いクリップは、1つの連続した動作として計画するとうまくいきます。
これらのAI動画トレンドを無料で試せますか?
はい。VIBEにはSeedance Pro Fast、LTX Video、Luma Dream Machine、Wan 2.6、PixVerseなどの無料モデルがあり、ログインなしで試せます。Veo 3.1 Fast、Kling 3 Pro、Wan 3.0などのプレミアムモデルでは、音声や長いクリップが使えます。
AI生成動画にラベルを付ける必要はありますか?
YouTubeでは、大幅に加工された、または合成されたリアルなコンテンツを、YouTube StudioのAI設定で開示する必要があります。他のプラットフォームには独自のルールがあるため、投稿前に確認してください。
今日から AI動画 を作り始めよう
iOSとAndroidでVIBEを無料ダウンロード。ログイン不要。10種類以上のAI動画モデルにアクセスし、テキストプロンプトや画像から動画を生成できます。