キャラクター 一貫性 AI動画の作り方:すべてのクリップで同じ顔を保つ方法
AI動画でキャラクターを一貫させるとは、ショットが変わっても同じ顔・髪・服装を保つことです。キャラクターが変わってしまう理由と、それを止める参照画像とプロンプトのワークフローを紹介します。
執筆 Vincent Park
公開日
キャラクター 一貫性 AI動画とは、生成するすべてのクリップで、同じ人物やキャラクターが同じ顔・髪・体型・服装で登場することを指します。実現するコツは、毎回同じ参照画像からショットを始めること、キャラクターを短く繰り返し使える説明文で固定すること、そして VIBE の Wan 3.0 のように参照ベースの生成に対応したモデルを選ぶことです。このガイドでは、コピーして使えるプロンプトとともに、ワークフロー全体を紹介します。
ひとことで言うと
キャラクター 一貫性 AI動画とは、毎回同じ参照画像と同じ固定のテキスト説明を土台に生成することで、複数のクリップにわたり1人のキャラクターの顔・髪・体型・服装を保つ手法のことです。
キャラクター 一貫性 AI動画とは?
AI動画モデルは、クリップごとにゼロから生成します。つなぎ止めるものを与えなければ、毎回新しい顔を作り出してしまいます。たとえば1本目で緑のジャケットを着た女性だった主人公が、2本目では明るいコートを着た別人になる、ということが起こります。キャラクター一貫性のあるAI動画とは、このランダム性をなくすための工夫の総称で、固定の参照画像、固定のテキスト説明、そしてその両方を尊重するモデルの組み合わせです。
特に効果が大きいのは、ショットが複数あるもの全般です。短いストーリー、投稿のたびに登場するマスコット、同じ案内役が出る商品解説、TikTok や YouTube Shorts の週次シリーズなどが当てはまります。単発のクリップならほとんど気にする必要はありませんが、シリーズでは、顔を覚えてもらえるチャンネルになるか、バラバラなクリップが並ぶだけのフィードになるかの分かれ目になります。
なぜAIキャラクターはクリップごとに変わってしまうのか?
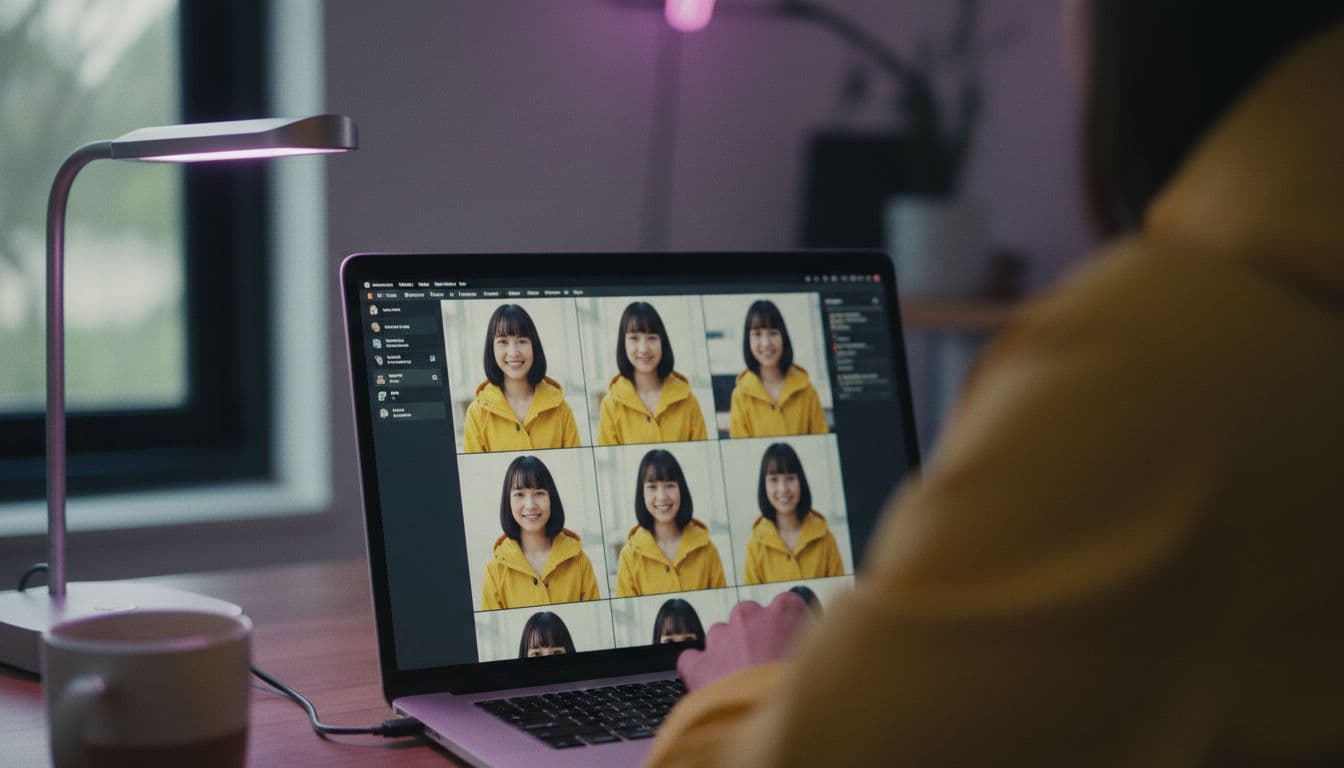
テキストから動画を作るモデルは、サンプリングによって言葉をピクセルに変換します。「緑のジャケットを着た若い女性」という説明は、何千通りもの顔に当てはまります。生成のたびに別の顔が選ばれるわけです。1本の短いクリップの中ならたいてい顔を保てますが、クリップ同士をつなぐものは、こちらが用意しない限り何もありません。
- あいまいな説明。「若い男性」では、年齢・顔の形・髪・肌の色をモデルが毎回自由に決められてしまいます。
- 視覚的なアンカーがない。 テキストだけのプロンプトでは、モデルが手本にできる画像がなく、クリップごとに人物が作り直されます。
- 状況の変化。 新しい照明、新しいカメラアングル、新しい場所によって、服装や顔のディテールが描き直されやすくなります。
- 長いクリップ。 1回の生成が長いほど、髪型が変わる、色味がずれるといった少しずつのズレが入り込む余地が増えます。
- モデルの混在。 同じ文章でも、異なるモデルが同じ顔を描くことはありません。
AI動画で同じキャラクターを保つには?
最も確実なのは、毎回モデルにキャラクターを考え出させるのをやめ、完成したキャラクターの画像を渡すことです。画像から動画を作る方法なら、まさにそれができます。写真が顔と服装を固定し、プロンプトでは動きだけを説明すれば済みます。基本は画像から動画を作るガイドで解説していますので、ここではキャラクター向けの手順を紹介します。
- クリーンなヒーロー画像を1枚作る。 無地の背景で、正面向き、均一な照明、腰から上のキャラクター画像が最適です。自分の写真、イラスト、生成した画像のどれでも使えます。
- キャラクターアンカーを書く。 年齢層、髪、服装、そして特徴的なディテールを1つ、短い2文でまとめます。すべてのプロンプトで一字一句同じにしてください。
- すべてのショットをヒーロー画像から生成する。 どのクリップも同じ画像から始め、変えるのは動作・カメラ・設定だけにします。
- 各クリップは短くする。 1ショットは数秒を目安にしてカットでつなぎ、ズレがたまりやすい長回しは避けます。
- 同じモデルを使い続ける。 シリーズ全体で1つのモデルを選んで使い続ければ、描画のスタイルがぶれません。
- よくできたフレームを保存する。 クリップの最後にキャラクターがうまく写っていたら、そのフレームを書き出して次のショットのヒーロー画像に使います。
 Wan 2.6
“Using the reference image: the same woman with short dark hair and a green bomber jacket walks toward the camera along a rainy city street at dusk, gentle handheld tracking shot, neon reflections on wet pavement. Keep her face, hair and jacket unchanged.”
変わらないキャラクターアンカーの書き方は?
キャラクターアンカーとは、キャラクターを説明する短い固定のテキストで、すべてのプロンプトの冒頭にそのまま貼り付けて使います。モデルがアレンジする余地をなくせるのが利点です。被写体・動作・カメラ・光という公式はAI動画プロンプトの書き方で説明していますが、アンカーはその「被写体」の部分を固定したものにほかなりません。
良いアンカーは、人の目が最初に気づく要素を具体的に書き、ショットごとに変わるべき要素には触れません。髪、服装、年齢層、そして目印になるディテールを1つ書きましょう。雰囲気、動作、場所は個々のショットの役割なので、アンカーには入れません。
 Seedance Pro Fast
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat. Mira sits at a café window and slowly turns a coffee cup in both hands, soft morning light, static medium shot, shallow depth of field.”
- すべてのプロンプトで同じ名前を使いましょう。名前はモデルにとっての取っ手の役割を果たします。
- 服装は毎回同じ順番で書きます。トップス、アウター、小物の順です。
- 「明るいコート」のようなあいまいな言葉より、「マスタードイエローのレインコート」のように具体的な色を使います。
- 1ショットで変えるのは1つだけ、動作か場所のどちらかにします。キャラクターは変えません。
リファレンス・トゥ・ビデオとは?どのモデルが対応している?
リファレンス・トゥ・ビデオ(参照から動画を生成)は、モデルが1枚以上の参照画像(場合によっては動画や音声も)を受け取り、そこに写る人物の特徴を保ったまま新しい動きを生成するモードです。参照を「アニメーションさせる最初のフレーム」ではなく「再利用するキャラクター」として扱うため、画像から動画を作る方法より一歩進んでいます。2026年10月時点では、Wan 3.0 が最も分かりやすい例です。Alibaba は、このリファレンス・トゥ・ビデオモードについて、キャラクターの顔立ち、髪型、体型、服装、アクセサリー、さらに小道具・空間・スタイルまで一貫して保つと説明しています。詳しくは Alibaba Cloud の Wan 3.0 発表記事をご覧ください。
このモデルを提供しているサードパーティのプラットフォームの情報では、最大10枚の参照画像、最長30秒、1080p出力に対応するとされていますが、正確な上限は利用する環境によって異なります。リファレンス・トゥ・ビデオはあくまでモデル自体の機能であり、特定のアプリの画面で使えることを保証するものではありません。そのため VIBE で今確実なのは、画像から動画を作る機能で質の高いヒーロー画像を1枚使う方法で、まず試すべきモデルは Wan 3.0 です。すべてのモデルは VIBE のモデル一覧で確認でき、WAN ファミリーについても読めます。 (Alibaba Cloud)
キャラクターを最も一貫して保てるAI動画モデルは?
完璧なモデルはなく、結果はモデルと同じくらい、参照画像とプロンプトにも左右されます。以下は、各モデルの位置づけと私たちの使い方をもとにした、キャラクター制作における VIBE モデルの実用的な役割です。
| モデル | VIBEでのティア | キャラクター制作での強み |
|---|---|---|
| Wan 3.0 | プレミアム | 参照ベースの生成と、同じキャラクターが続く長めのショット |
| Kling 3 Pro | プレミアム | アングルを切り替えるカット入りのマルチショットシーケンス |
| Seedance Pro Fast | 無料 | プレミアムを使う前にキャラクターアンカーを手早くテストする |
| Wan 2.6 | 無料 | ヒーロー画像からの画像→動画。無料で始めるしっかりした選択肢 |
おすすめの流れは、まず無料モデルでアンカーとヒーロー画像をテストすることです。キャラクターの見た目が決まったら、採用するショットをプレミアムモデルで生成し直します。強みの詳細はモデル比較で、マルチショットの挙動は Kling 3 のページで解説しています。
シリーズ全体でキャラクターを一貫させるには?
シリーズでは、キャラクターを小さな制作バイブルのように扱いましょう。アンカー、ヒーロー画像のファイル、モデル、アスペクト比を書き留めて、毎エピソードで使い回します。1週間後に戻ってきても、記憶に頼らずまったく同じ設定を再現できるようにしておくのが狙いです。
- キャラクターシートを作る。 ヒーロー画像、アンカーのテキスト、承認済みの追加アングル2〜3枚を1つの資料にまとめます。
- フォーマットを固定する。 9:16 か 16:9 を最初に決めて変えないこと。フレームが変わると、モデルの顔の描き方も変わります。
- 変えるのは世界で、主人公ではない。 アンカーは同一のまま、場所や時間帯を変えていきます。
- 公開前に見比べる。 編集でつなぐ前に、クリップを並べて顔・髪・服装を確認します。
- カットを味方にする。 短い2つのショットを素早くつなぐほうが、1つの長回しよりわずかな違いをずっと目立たなくできます。
 Kling 3 Pro
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat, stands on a ferry deck at sunrise looking at the skyline, wind moving her coat, slow push-in from medium to close-up, calm cinematic mood.”
キャラクターの一貫性が崩れる原因と対処法は?
失敗の多くは、避けられるいくつかの習慣から生まれます。キャラクターが急に別人のようになったら、モデルのせいにする前に、次の項目を順に確認してください。
- アンカーの言い換え。 わずかな修正でも結果は変わります。打ち直さず、コピー&ペーストしましょう。
- ごちゃついた参照画像。 複数人が写っている、サングラスをかけている、影が強いといった写真は、モデルが頼れる情報が減ります。クリーンなポートレートを使ってください。
- 極端なアングルと速い動き。 横顔、回転、素早いアクションは、顔が最も変わりやすい場面です。まずは落ち着いた正面のショットから始めましょう。
- シリーズの途中でのモデル変更。 モデルごとに顔の描き方が違うため、シリーズは1つのモデルで完結させます。
- 1クリップに詰め込みすぎ。 複数の動作にカメラの動きと場所の変更まで加えると、ズレが起きやすくなります。2つのショットに分けましょう。
使うのは、自分自身の画像、オリジナルキャラクター、または表示することに同意した人の画像だけにしてください。キャラクターの一貫性はクリエイティブなツールであり、どんなポートレートにも払うべき配慮はここでも同じです。アプリ内の手順を最初から確認したい方は、使い方をご覧ください。
よくある質問
AI動画で同じキャラクターを保つにはどうすればいいですか?
毎回同じクリーンな参照画像からクリップを始め、同一のキャラクター説明をすべてのプロンプトに貼り付け、ショットは短くし、シリーズ全体で1つのモデルを使います。画像から動画を作る方法が最も確実で、画像が顔と服装を固定してくれます。
AI動画のプロンプトにおけるキャラクターアンカーとは何ですか?
キャラクターアンカーとは、名前、年齢層、髪、服装、特徴的なディテールをまとめた短い固定の説明文です。すべてのプロンプトの冒頭に一字一句そのまま貼り付けることで、モデルがアレンジする余地を減らします。
AI動画生成におけるリファレンス・トゥ・ビデオとは何ですか?
モデルが参照画像(場合によっては動画や音声も)を受け取り、そこに写る人物の特徴を保ったまま新しい動きを生成するモードです。Wan 3.0 が現在の一例で、Alibaba はキャラクターの顔、髪、体型、服装を一貫して保つと説明しています。
キャラクターの一貫性に最適な VIBE のモデルはどれですか?
参照ベースの一貫性ではまず Wan 3.0 を試してください。マルチショットのシーケンスには Kling 3 Pro が有力です。Seedance Pro Fast と Wan 2.6 は無料で、プレミアムの生成を使う前にキャラクターをテストするのに向いています。
なぜ私のAIキャラクターは動画ごとに違って見えるのですか?
生成のたびにゼロから始まり、あいまいなテキスト説明は多くの顔に当てはまるからです。参照画像と固定の説明がなければ、モデルは毎回新しい顔を選びます。長いクリップ、新しい照明、極端なアングルがさらにズレを増やします。
一貫性のあるキャラクターを無料で作れますか?
はい。VIBE はログイン不要で無料で始められ、無料モデルの Seedance Pro Fast と Wan 2.6 でヒーロー画像とアンカープロンプトをテストできます。プレミアムモデルは最終ショットのときだけ使えば十分です。
キャラクターの一貫性を保つには、クリップをどのくらいの長さにすべきですか?
短いほうが安全です。数秒のショットをカットでつなぐほうが、1つの長回しよりズレにくくなります。モデルによっては長いクリップも可能ですが、使う前に最後の顔と服装を必ず確認してください。
今日から AI動画 を作り始めよう
iOSとAndroidでVIBEを無料ダウンロード。ログイン不要。10種類以上のAI動画モデルにアクセスし、テキストプロンプトや画像から動画を生成できます。