일관된 캐릭터 AI 영상: 모든 클립에서 같은 얼굴을 유지하는 방법
AI 영상에서 캐릭터가 일관되다는 것은 장면이 바뀌어도 얼굴, 헤어, 의상이 그대로라는 뜻입니다. 캐릭터가 달라지는 이유와 이를 막아 주는 참조 이미지·프롬프트 워크플로를 소개합니다.
작성자 Vincent Park
게시일
일관된 캐릭터 AI 영상이란 생성하는 모든 클립에서 같은 인물(또는 크리처)이 같은 얼굴, 헤어, 체형, 의상으로 등장하는 영상을 말합니다. 모든 샷을 같은 참조 이미지에서 시작하고, 짧고 반복 가능한 설명으로 캐릭터를 고정하고, VIBE의 Wan 3.0처럼 참조 기반 생성을 지원하는 모델을 고르면 됩니다. 이 가이드에서는 바로 붙여 넣어 쓸 수 있는 프롬프트와 함께 전체 워크플로를 보여 드립니다.
한 문장 요약
일관된 캐릭터 AI 영상은 매번 같은 참조 이미지와 같은 고정 텍스트 설명으로 생성을 고정해, 여러 클립에 걸쳐 한 캐릭터의 얼굴, 헤어, 체형, 의상을 그대로 유지하는 제작 방식입니다.
일관된 캐릭터 AI 영상이란?
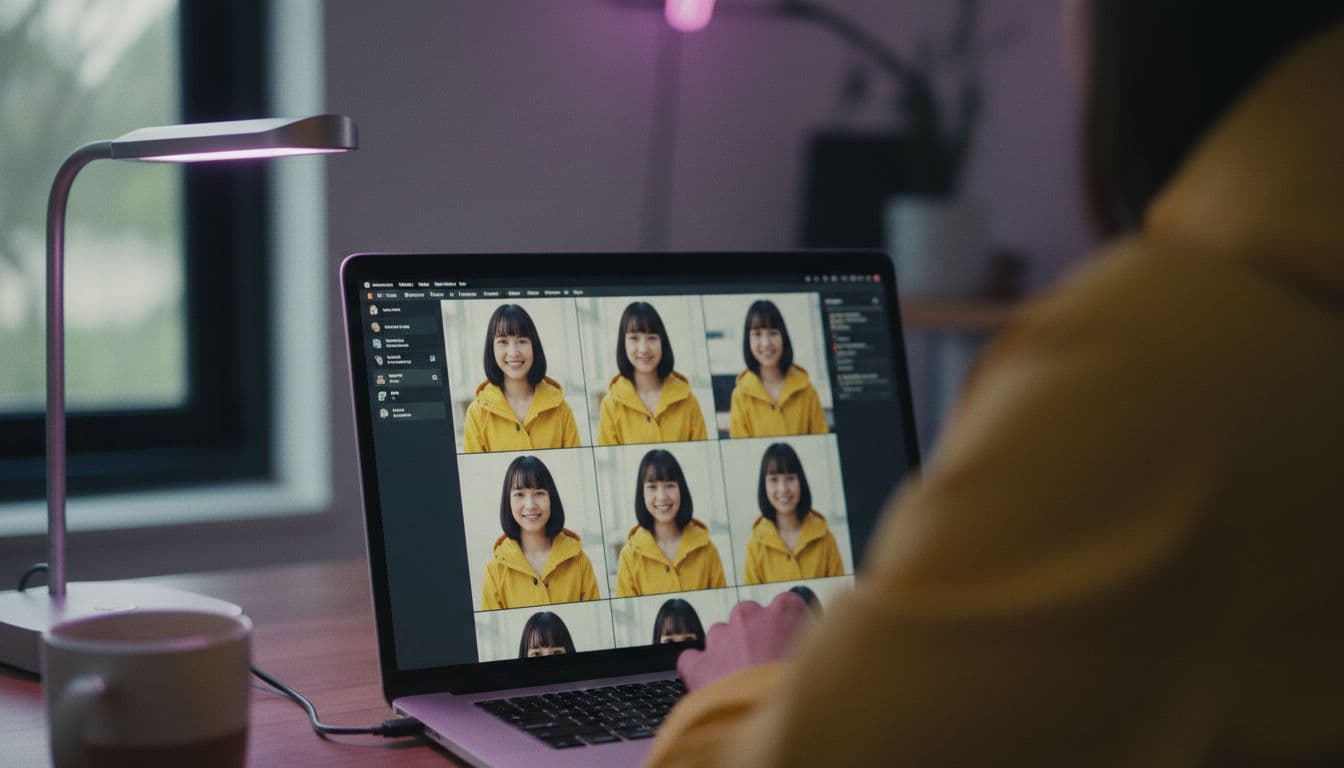
AI 영상 모델은 클립마다 처음부터 새로 생성합니다. 붙잡을 고정된 기준을 주지 않으면 매번 새로운 얼굴을 만들어 내기 때문에, 첫 번째 클립에서 초록 재킷을 입은 여성이 두 번째 클립에서는 밝은 코트를 입은 전혀 다른 여성이 되기도 합니다. 일관된 캐릭터 AI 영상은 이런 무작위성을 없애는 습관의 묶음입니다. 고정된 참조 이미지, 고정된 텍스트 설명, 그리고 둘을 모두 잘 따르는 모델이 그 핵심입니다.
샷이 두 개 이상인 작업이라면 특히 중요합니다. 짧은 스토리, 게시물마다 등장하는 마스코트, 고정 진행자가 나오는 제품 설명 영상, TikTok이나 YouTube Shorts의 주간 시리즈가 대표적입니다. 단독 클립 하나라면 대부분 건너뛰어도 됩니다. 하지만 시리즈라면 알아볼 수 있는 얼굴이 있는 채널과 서로 무관한 클립이 뒤섞인 피드를 가르는 차이가 됩니다.
AI 캐릭터는 왜 클립마다 달라질까요?
텍스트-투-비디오 모델은 샘플링을 통해 글을 픽셀로 바꾸는데, "초록 재킷을 입은 젊은 여성"이라는 설명은 수천 가지 다른 얼굴에 들어맞습니다. 새로 생성할 때마다 다른 얼굴이 선택되는 셈입니다. 짧은 클립 하나 안에서는 대체로 얼굴을 안정적으로 유지하지만, 클립 사이를 이어 주는 연결고리를 직접 주지 않으면 아무것도 둘을 묶어 주지 않습니다.
- 모호한 설명. "젊은 남자"라고만 쓰면 나이, 얼굴형, 헤어, 피부색을 매번 모델 마음대로 고르게 됩니다.
- 시각적 기준 부재. 텍스트만 있는 프롬프트에는 따라 그릴 이미지가 없어서 클립마다 정체성이 새로 만들어집니다.
- 바뀌는 환경. 조명, 카메라 앵글, 장소가 바뀌면 모델이 의상과 얼굴 디테일을 다시 그리게 됩니다.
- 긴 클립. 한 번에 생성하는 길이가 길수록 헤어스타일이 바뀌거나 색감이 변하는 식의 점진적 변형이 생길 여지가 커집니다.
- 모델 혼용. 서로 다른 두 모델은 같은 문장으로도 같은 얼굴을 그리지 않습니다.
AI 영상에서 같은 캐릭터를 유지하려면?
가장 확실한 방법은 클립마다 모델에게 캐릭터를 새로 만들어 내라고 요구하는 대신, 완성된 캐릭터 그림을 건네는 것입니다. 이미지-투-비디오가 바로 그 역할을 합니다. 사진이 얼굴과 의상을 고정하고, 프롬프트는 움직임만 설명하면 됩니다. 기본기는 이미지-투-비디오 가이드에서 다루었고, 여기서는 캐릭터에 특화된 방법을 소개합니다.
- 깔끔한 히어로 이미지 한 장 만들기. 단색 배경에서 정면을 보고 고르게 조명을 받은 허리 위 사진이 가장 좋습니다. 직접 찍은 사진, 일러스트, 생성한 이미지 모두 괜찮습니다.
- 캐릭터 앵커 작성하기. 나이대, 헤어, 의상, 눈에 띄는 특징 하나를 담은 짧은 두 문장입니다. 모든 프롬프트에서 한 글자도 바꾸지 않고 그대로 씁니다.
- 모든 샷을 히어로 이미지에서 생성하기. 매 클립을 같은 이미지로 시작하고, 동작, 카메라, 배경만 바꿉니다.
- 클립을 짧게 유지하기. 변형이 쌓일 수 있는 긴 원테이크 대신 샷당 몇 초로 끊어서 컷으로 연결하세요.
- 같은 모델 계속 쓰기. 시리즈에 쓸 모델을 하나 정해 끝까지 사용하면 화풍이 흔들리지 않습니다.
- 마음에 드는 프레임 저장하기. 캐릭터가 잘 나온 장면으로 클립이 끝났다면, 그 프레임을 내보내 다음 샷의 히어로 이미지로 사용하세요.
 Wan 2.6
“Using the reference image: the same woman with short dark hair and a green bomber jacket walks toward the camera along a rainy city street at dusk, gentle handheld tracking shot, neon reflections on wet pavement. Keep her face, hair and jacket unchanged.”
변하지 않는 캐릭터 앵커는 어떻게 쓸까요?
캐릭터 앵커는 캐릭터를 묘사하는 짧은 고정 문구로, 모든 프롬프트의 맨 앞에 그대로 붙여 넣습니다. 모델이 즉흥적으로 바꿀 여지를 없애 주기 때문에 효과가 있습니다. 피사체, 동작, 카메라, 빛으로 이루어진 공식은 AI 영상 프롬프트 작성법에서 설명했는데, 앵커는 그중 피사체 부분을 고정해 둔 것이라고 보면 됩니다.
좋은 앵커는 눈에 가장 먼저 들어오는 요소를 구체적으로 적고, 샷마다 달라져야 하는 요소는 일절 언급하지 않습니다. 헤어, 의상, 나이대, 시그니처 디테일 하나를 적으세요. 분위기, 동작, 장소는 각 샷에 속하는 내용이므로 빼야 합니다.
 Seedance Pro Fast
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat. Mira sits at a café window and slowly turns a coffee cup in both hands, soft morning light, static medium shot, shallow depth of field.”
- 모든 프롬프트에서 캐릭터 이름을 똑같이 쓰세요. 이름은 모델이 캐릭터를 붙잡는 손잡이 역할을 합니다.
- 의상은 매번 같은 순서로 나열하세요. 상의, 겉옷, 액세서리 순입니다.
- "밝은 코트" 같은 막연한 표현보다 "머스터드 옐로 레인코트"처럼 구체적인 색을 쓰세요.
- 샷마다 하나만 바꾸세요. 동작이나 장소 중 하나만 바꾸고, 캐릭터는 절대 바꾸지 않습니다.
레퍼런스-투-비디오란 무엇이고, 어떤 모델이 지원하나요?
레퍼런스-투-비디오는 모델이 하나 이상의 참조 이미지(때로는 영상이나 오디오)를 받아, 그 안에 담긴 정체성을 유지한 채 새로운 움직임을 만들어 내는 생성 모드입니다. 참조를 애니메이션으로 만들 첫 프레임이 아니라 재사용할 캐릭터로 취급한다는 점에서 이미지-투-비디오보다 한 걸음 더 나아간 방식입니다. 2026년 10월 기준으로 Wan 3.0이 가장 뚜렷한 사례입니다. Alibaba는 레퍼런스-투-비디오 모드가 캐릭터의 이목구비, 헤어스타일, 체형, 의상, 액세서리는 물론 소품, 공간, 스타일까지 일관되게 유지한다고 설명합니다. 자세한 내용은 Alibaba Cloud의 Wan 3.0 발표에서 확인할 수 있습니다.
이 모델을 제공하는 외부 플랫폼들은 최대 10장의 참조 이미지, 최대 30초 길이, 1080p 출력을 지원한다고 밝히고 있으며, 정확한 한도는 실행하는 곳에 따라 다릅니다. 레퍼런스-투-비디오 모드는 모델 자체의 기능일 뿐 특정 앱의 인터페이스를 보장하는 것은 아닙니다. 그래서 VIBE에서는 현재 이미지-투-비디오에 좋은 히어로 이미지 한 장을 쓰는 것이 가장 믿을 만한 방법이며, 가장 먼저 시도할 모델은 Wan 3.0입니다. 모든 모델은 VIBE 모델 목록에서 볼 수 있고, WAN 시리즈 소개도 읽어 보세요. (Alibaba Cloud)
캐릭터를 가장 일관되게 유지하는 AI 영상 모델은?
완벽한 모델은 없으며, 결과는 모델만큼이나 참조 이미지와 프롬프트에 좌우됩니다. 아래는 각 모델의 포지셔닝과 저희가 실제로 쓰는 방식을 바탕으로 정리한, 캐릭터 작업에서 VIBE 모델이 맡는 실질적인 역할입니다.
| 모델 | VIBE 등급 | 캐릭터 작업에 적합한 용도 |
|---|---|---|
| Wan 3.0 | 프리미엄 | 참조 기반 생성, 한 캐릭터가 계속 등장하는 긴 샷 |
| Kling 3 Pro | 프리미엄 | 앵글 사이에 컷을 넣고 싶은 멀티샷 시퀀스 |
| Seedance Pro Fast | 무료 | 프리미엄을 쓰기 전에 캐릭터 앵커를 빠르게 테스트 |
| Wan 2.6 | 무료 | 히어로 이미지로 하는 이미지-투-비디오, 든든한 무료 출발점 |
먼저 무료 모델로 앵커와 히어로 이미지를 테스트해 보는 것이 합리적인 워크플로입니다. 캐릭터가 마음에 들면 건질 만한 샷만 프리미엄 모델로 다시 생성하세요. 각 모델의 강점은 모델 비교에서 더 자세히 다루고, 멀티샷 동작은 Kling 3 페이지에서 설명합니다.
시리즈 전체에서 캐릭터를 일관되게 유지하려면?
시리즈라면 캐릭터를 작은 제작 바이블처럼 관리하세요. 앵커, 히어로 이미지 파일, 모델, 화면 비율을 적어 두고 모든 에피소드에서 그대로 재사용합니다. 일주일 뒤에 돌아왔을 때 기억에 의존하지 않고 똑같은 설정을 그대로 재현할 수 있어야 합니다.
- 캐릭터 시트 만들기. 히어로 이미지, 앵커 문구, 승인된 추가 앵글 두세 장을 한 문서에 모아 두세요.
- 포맷 고정하기. 9:16 또는 16:9 중 하나를 정해 계속 쓰세요. 프레임이 바뀌면 모델이 얼굴을 그리는 방식도 달라집니다.
- 바꿀 것은 세계, 주인공이 아닙니다. 앵커는 그대로 두고 장소와 시간대만 바꿔 가며 이동하세요.
- 게시 전에 검토하기. 편집으로 이어 붙이기 전에 클립을 나란히 놓고 얼굴, 헤어, 의상을 확인하세요.
- 컷을 활용하기. 짧은 두 샷 사이의 빠른 컷은 긴 원테이크보다 작은 차이를 훨씬 잘 가려 줍니다.
 Kling 3 Pro
“Mira, a woman in her late twenties with a short dark bob, round gold earrings and a mustard-yellow raincoat, stands on a ferry deck at sunrise looking at the skyline, wind moving her coat, slow push-in from medium to close-up, calm cinematic mood.”
캐릭터 일관성이 깨지는 원인과 해결법은?
대부분의 실패는 피할 수 있는 몇 가지 습관에서 비롯됩니다. 캐릭터가 갑자기 달라 보인다면 모델을 탓하기 전에 아래 목록부터 점검해 보세요.
- 앵커 문구 바꿔 쓰기. 사소한 수정도 결과를 바꿉니다. 다시 타이핑하지 말고 복사해서 붙여 넣으세요.
- 어수선한 참조 이미지. 여러 사람이 나오거나, 선글라스를 썼거나, 그림자가 짙은 사진은 모델이 붙잡을 단서가 적습니다. 깔끔한 인물 사진을 쓰세요.
- 극단적인 앵글과 빠른 움직임. 옆모습, 회전, 빠른 액션에서 얼굴이 가장 자주 바뀝니다. 차분한 정면 샷부터 시작하세요.
- 시리즈 도중에 모델 바꾸기. 모델마다 얼굴을 그리는 방식이 다르니 시리즈는 한 모델로 끝까지 가세요.
- 한 클립에 너무 많이 요구하기. 여러 동작에 카메라 움직임과 장소 변경까지 더하면 변형이 생기기 쉽습니다. 두 샷으로 나누세요.
본인의 이미지, 직접 만든 캐릭터, 또는 등장에 동의한 사람의 이미지만 사용하세요. 일관된 캐릭터는 창작 도구이며, 어떤 인물 사진에든 기울일 법한 주의가 여기에도 똑같이 적용됩니다. 앱 안에서의 전체 단계별 흐름은 이용 방법에서 확인하세요.
자주 묻는 질문
AI 영상에서 같은 캐릭터를 유지하려면 어떻게 해야 하나요?
모든 클립을 같은 깔끔한 참조 이미지에서 시작하고, 모든 프롬프트에 동일한 캐릭터 설명을 붙여 넣고, 샷을 짧게 유지하고, 시리즈 전체에 한 모델만 사용하세요. 사진이 얼굴과 의상을 고정해 주기 때문에 이미지-투-비디오가 가장 확실한 방법입니다.
AI 영상 프롬프트에서 캐릭터 앵커란 무엇인가요?
캐릭터 앵커는 이름, 나이대, 헤어, 의상, 눈에 띄는 특징 하나를 담은 짧은 고정 설명입니다. 모든 프롬프트 맨 앞에 한 글자도 바꾸지 않고 붙여 넣어, 모델이 즉흥적으로 바꿀 여지를 줄여 줍니다.
AI 영상 생성에서 레퍼런스-투-비디오란 무엇인가요?
레퍼런스-투-비디오는 모델이 참조 이미지(때로는 영상이나 오디오)를 받아, 그 안의 정체성을 유지한 채 새로운 움직임을 생성하는 모드입니다. 현재 Wan 3.0이 대표적이며, Alibaba는 캐릭터의 얼굴, 헤어, 체형, 의상을 일관되게 유지한다고 밝혔습니다.
일관된 캐릭터에는 어떤 VIBE 모델이 가장 좋나요?
참조 기반 일관성은 Wan 3.0을 가장 먼저 써 보시길 권하고, 멀티샷 시퀀스에는 Kling 3 Pro가 좋은 선택입니다. Seedance Pro Fast와 Wan 2.6은 무료여서 프리미엄 생성을 쓰기 전에 캐릭터를 테스트하기에 좋습니다.
내 AI 캐릭터가 영상마다 다르게 보이는 이유는 무엇인가요?
생성할 때마다 처음부터 새로 시작하는 데다, 모호한 텍스트 설명은 많은 얼굴에 들어맞기 때문입니다. 참조 이미지와 고정된 설명이 없으면 모델이 매번 새로운 얼굴을 고릅니다. 긴 클립, 새로운 조명, 극단적인 앵글은 변형을 더 키웁니다.
일관된 캐릭터를 무료로 만들 수 있나요?
네. VIBE는 로그인 없이 무료로 시작할 수 있고, 무료 모델인 Seedance Pro Fast와 Wan 2.6으로 히어로 이미지와 앵커 프롬프트를 테스트할 수 있습니다. 최종 샷에만 프리미엄 모델로 업그레이드하세요.
캐릭터를 일관되게 유지하려면 클립은 얼마나 길어야 하나요?
짧을수록 안전합니다. 샷당 몇 초씩 끊어 컷으로 잇는 편이 긴 원테이크보다 변형이 적습니다. 일부 모델은 더 긴 클립도 가능하지만, 사용하기 전에 끝부분의 얼굴과 의상을 꼭 확인하세요.
오늘 AI 영상을 만들어 보세요
iOS 및 Android에서 VIBE를 무료로 다운로드하세요. 로그인이 필요 없습니다. 10개 이상의 AI 영상 모델에 접근하고 텍스트 프롬프트나 이미지에서 영상을 생성하세요.