AI 영상 트렌드 2026: 무엇이 바뀌고 어떻게 활용할까
소리, 더 긴 테이크, 일관된 캐릭터, 세로 포맷, 공개 규칙이 올해 AI 영상을 바꾸고 있습니다. 각 트렌드의 의미와 활용법을 알려드립니다.
작성자 Vincent Park
게시일
가장 큰 AI 영상 트렌드 2026은 네이티브 오디오, 더 긴 원테이크, 레퍼런스를 통한 캐릭터 일관성, 세로형 우선, 그리고 AI 콘텐츠의 더 분명한 표시입니다. 2026년 10월 기준으로 대부분을 이미 VIBE에서 쓸 수 있습니다. 이 가이드는 각 트렌드가 내 클립에 어떤 의미인지, 바로 복사해 쓸 수 있는 프롬프트와 함께 설명합니다.
한 문장으로
AI 영상 트렌드 2026은 올해 AI 영상 모델과 플랫폼이 작동하는 방식의 변화를 말합니다. 화면과 함께 생성되는 소리, 수 초 이상 이어지는 클립, 캐릭터를 일관되게 유지하는 레퍼런스 입력, 9:16을 먼저 고려한 포맷, AI로 만든 콘텐츠의 공개 규칙이 그것입니다.
2026년 가장 큰 AI 영상 트렌드는 무엇인가요?
눈에 띄는 변화는 다섯 가지이며, 모두 추측이 아니라 최근 몇 달간의 모델 발표에서 확인할 수 있습니다. 모델이 화면과 함께 소리를 생성하고, 단일 클립이 길어지고, 레퍼런스 입력으로 캐릭터를 재현할 수 있고, 세로 영상이 부차적인 것이 아니라 기본이 되었으며, 플랫폼은 AI 콘텐츠 표시를 강화하고 있습니다. 기본부터 알고 싶다면 이 모든 트렌드의 바탕이 되는 문장 구조를 다룬 AI 영상 프롬프트 작성 가이드를 먼저 읽어보세요.
- 네이티브 오디오: 대사, 효과음, 분위기 소리가 화면과 같은 렌더링으로 나옵니다.
- 더 긴 테이크: 8초부터 발표상 최대 30초까지의 클립이 장면을 계획하는 방식을 바꿉니다.
- 레퍼런스 기반 일관성: 사진, 일부 모델에서는 영상과 오디오가 화면에 나오는 인물과 사물을 정합니다.
- 세로형 우선: 9:16은 나중에 자르는 것이 아니라 모델이 그에 맞춰 구도를 잡는 표준 포맷입니다.
- 공개와 라벨: 플랫폼은 사실적인 콘텐츠가 AI로 만들어졌음을 밝히도록 점점 더 요구합니다.
네이티브 오디오는 이제 AI 영상의 표준인가요?
상위 모델에서는 표준이 되어 가고 있지만 아직 보편적이지는 않습니다. Google DeepMind는 Veo 3.1이 효과음, 주변 소리, 대사를 추가할 수 있으며 모든 오디오를 네이티브로 생성한다고 밝혔고, Alibaba의 Wan 3.0 발표는 이 모델이 네이티브 오디오·영상 생성을 지원한다고 설명합니다.
VIBE 안에서는 상황이 더 구체적입니다. 2026년 10월 기준으로 Veo 3.1 Fast와 Kling 3 Pro는 영상과 함께 소리를 생성하고, Wan 3.0을 포함한 VIBE의 나머지 모델은 영상만 생성합니다. 두 모델은 오디오 포함 AI 영상 가이드에서 자세히 비교합니다. 실전 규칙은 카메라와 조명을 쓰듯 소리도 프롬프트에 직접 쓰고, 누가 말하며 무엇을 말하는지도 적는 것입니다.
 Veo 3.1 Fast
“A street musician plays violin on a rainy corner at dusk, a passer-by says "Beautiful tune" and drops a coin in the case, close-up of the bow, warm shop light, rain on the pavement, soft violin music and rain ambience, vertical 9:16”
2026년 AI 영상 클립은 얼마나 길 수 있나요?
클립 길이는 모델마다 크게 달라서 그에 맞춰 계획할 가치가 있습니다. Google은 Veo 클립을 8초이며 장면 확장으로 늘릴 수 있다고 설명하고, VIBE의 Kling 3 Pro는 15초까지 가능하며, Alibaba는 Wan 3.0이 최대 1080p로 최장 30초 영상을 만들 수 있다고 밝혔습니다. 아래 표에서 세 모델을 나란히 비교합니다.
| 모델 | 개발사 | 클립 길이 | VIBE의 소리 |
|---|---|---|---|
| Veo 3.1 Fast | Google DeepMind | 8초 | 예(네이티브) |
| Kling 3 Pro | Kuaishou | 최대 15초 | 예(네이티브) |
| Wan 3.0 | Alibaba | 최대 30초(Alibaba 발표) | 영상만 |
더 긴 테이크가 자동으로 더 좋은 것은 아닙니다. 모델이 채워야 할 초 수가 늘수록 결과가 어긋나기 쉬우므로, 클립마다 하나의 연속 동작만 쓰고 이야기는 카메라에 맡기세요. 여러 장면이 필요하면 여러 클립을 생성해 이어 붙이면 됩니다. Wan 모델 페이지에서 이 모델 계열이 움직임을 어떻게 다루는지 볼 수 있으며, 한 동작 규칙은 표의 모든 모델에 적용됩니다.
레퍼런스 이미지는 어떻게 캐릭터 일관성을 유지하나요?
레퍼런스 입력을 쓰면 캐릭터나 사물을 처음부터 설명하는 대신 모델에게 모습을 보여줄 수 있습니다. DeepMind는 Veo 3.1이 캐릭터, 스타일, 사물에 대한 레퍼런스 이미지를 받는다고 밝혔고, Alibaba는 Wan 3.0이 최대 이미지 10장, 영상 5개, 오디오 5개를 레퍼런스로 조합할 수 있다고 밝혔습니다. VIBE에서 현재 가장 믿을 만한 방법은 이미지-투-비디오입니다. 사진을 영상으로 바꾸는 가이드에서 설명하듯, 얼굴, 의상, 배경을 고정해 주는 사진 한 장에서 시작하세요.
- 피사체가 선명하고 조명이 좋은 대표 이미지를 하나 골라 모든 클립의 시작 프레임으로 사용하세요.
- 의상과 머리 같은 캐릭터 설명을 모든 프롬프트에서 똑같이 쓰고 동작만 바꾸세요.
- 클립당 동작은 하나로 해서 모델이 캐릭터에 대해 더 만들어낼 것이 없게 하세요.
- 렌즈, 조명, 색보정 같은 스타일 표현을 모든 프롬프트에서 반복하세요.
 Kling 3 Pro
“Using the uploaded photo as the first frame: the woman in the green raincoat turns toward the camera and smiles, then walks forward along the same market street, handheld camera at eye level, natural overcast light, same outfit and hairstyle throughout”
왜 세로 9:16이 이제 기본 포맷일까요?
AI 영상 대부분은 TikTok, 인스타그램 릴스, YouTube 쇼츠에서 휴대폰으로 시청되기 때문에 모델과 앱은 이제 9:16을 일급 포맷으로 다룹니다. DeepMind는 세로 9:16 출력을 Veo 3.1의 기능으로 꼽는데, 이는 가로 화면을 잘라내는 대신 세로로 긴 프레임에 맞춰 구도를 잡는다는 뜻입니다. 자르기를 하면 피사체나 계획한 동작이 잘릴 수 있으므로 네이티브 구도가 중요합니다.
- 피사체를 프레임의 가운데 3분의 1에 두고, 앱 버튼과 자막이 있는 가장자리는 피하세요.
- 피사체는 하나로 분명하게, 배경은 단순하게 하세요. 휴대폰 화면에서는 작은 디테일이 사라집니다.
- 위로 틸트하거나 피사체가 카메라 쪽으로 걸어오는 것처럼 세로 방향 움직임을 써서 프레임의 높이를 활용하세요.
- 나중에 자르지 말고 생성하기 전에 9:16을 선택하세요.
 Seedance Pro Fast
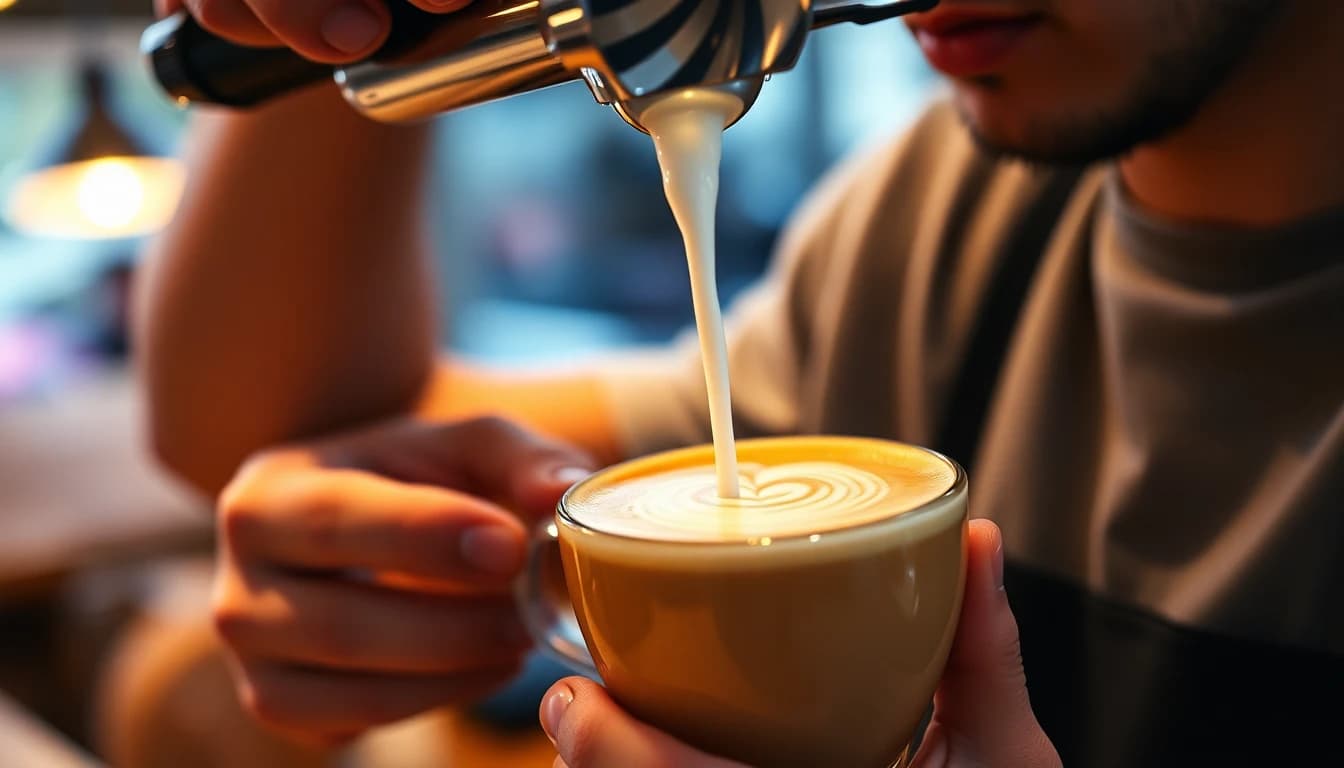
“Close-up of a barista pouring steamed milk into a latte, latte art forming, slow tilt up from the cup to a smiling face, warm cafe light, shallow depth of field, vertical 9:16”
Sora에 무슨 일이 있었고, 왜 중요한가요?
OpenAI는 도움말 센터에서 설명하듯 Sora의 일반 사용을 종료했으며, 일정과 대안은 Sora 2 설명 글에서 다룹니다. 크리에이터에게 주는 교훈은 영구적인 모델은 없다는 것입니다. 프롬프트를 다른 모델에서도 쓸 수 있게 하고, 좋은 프롬프트는 저장해 두고, 여러 모델을 제공하는 앱을 쓰면 모델이 바뀌거나 종료되어도 작업이 멈추지 않습니다. VIBE는 무료 모델을 포함한 여러 모델을 하나의 앱에서 제공합니다.
2026년에 AI 영상에 라벨을 붙여야 하나요?
YouTube에서는 콘텐츠가 사실적이라면 그렇습니다. YouTube 정책은 사실적으로 보이는 크게 변형되었거나 합성된 콘텐츠를 공개하도록 요구하며, 실사 같은 콘텐츠는 플레이어에, 애니메이션이나 분명히 비현실적인 콘텐츠는 설명란에 라벨이 표시됩니다. YouTube는 공개해도 도달 범위나 수익 창출이 제한되지 않는다고 하지만, 반복해서 공개하지 않으면 YouTube가 라벨을 붙이거나 콘텐츠를 삭제하거나 파트너 프로그램에서 정지될 수 있습니다. 규칙은 플랫폼마다 다르고 자주 바뀌므로 게시 전에 최신 도움말 페이지를 확인하세요.
- 실제 사건이나 실제 인물로 오해할 수 있는 사실적인 AI 장면은 공개하세요.
- 실제 인물이 하지 않은 말이나 행동을 한 것처럼 보이게 하는 데 AI를 쓰지 마세요.
- 시청자가 알아채기를 기대하지 말고 업로드할 때 AI 설정을 사용하세요.
오늘 VIBE에서 이 트렌드를 어떻게 쓸 수 있나요?
- iOS, Android 또는 웹에서 VIBE를 열고 Seedance Pro Fast 같은 무료 모델로 시작하세요. 체험에는 로그인이 필요 없습니다.
- 클립당 동작 하나를 쓰고, 숏폼 플랫폼용으로 포맷을 9:16으로 설정하세요.
- 대사와 소리가 필요하면 Veo 3.1 Fast나 Kling 3 Pro로, 더 긴 테이크가 필요하면 Wan 3.0으로 바꾸세요.
- 사실적인 클립은 업로드할 때 라벨을 붙이고, 좋은 프롬프트는 재사용을 위해 보관하세요.
전체 모델 목록과 무료 모델은 VIBE 모델 섹션에서 확인하고, 아래 프롬프트로 더 긴 테이크를 시험해 보세요.
 Wan 3.0
“One continuous shot following a hiker along a ridge trail at sunrise, the camera drifts slowly beside them as mist lifts from the valley, steady pace, soft golden light, natural motion, no cuts”
자주 묻는 질문
2026년 주요 AI 영상 트렌드는 무엇인가요?
AI 영상 트렌드 2026의 핵심은 네이티브 오디오, 더 긴 단일 클립, 레퍼런스 기반 일관성, 세로 9:16 출력, 그리고 AI 콘텐츠의 더 분명한 공개입니다. 2026년 10월 기준 Veo 3.1, Kling 3 Pro, Wan 3.0 같은 모델은 이 중 여러 가지를 동시에 보여줍니다.
어떤 AI 영상 모델이 소리를 자동으로 생성하나요?
VIBE에서는 Google DeepMind의 Veo 3.1 Fast와 Kuaishou의 Kling 3 Pro가 영상과 함께 소리를 생성합니다. 무료 모델을 포함한 VIBE의 나머지 모델은 현재 영상만 만들기 때문에 음악이나 내레이션은 나중에 추가합니다.
2026년 AI 영상은 얼마나 길 수 있나요?
모델에 따라 다릅니다. Veo 3.1 Fast는 8초 클립, Kling 3 Pro는 최대 15초이며, Alibaba는 Wan 3.0이 최대 30초를 생성할 수 있다고 밝혔습니다. 긴 클립은 하나의 연속 동작으로 계획할 때 가장 잘 작동합니다.
이런 AI 영상 트렌드를 무료로 체험할 수 있나요?
네. VIBE에는 Seedance Pro Fast, LTX Video, Luma Dream Machine, Wan 2.6, PixVerse 같은 무료 모델이 있으며 로그인 없이 써볼 수 있습니다. Veo 3.1 Fast, Kling 3 Pro, Wan 3.0 같은 프리미엄 모델은 소리나 더 긴 클립을 제공합니다.
AI로 만든 영상에 라벨을 붙여야 하나요?
YouTube에서는 크게 변형되었거나 합성된 사실적인 콘텐츠를 YouTube 스튜디오의 AI 설정으로 공개해야 합니다. 다른 플랫폼은 자체 규칙이 있으니 게시 전에 확인하세요.
오늘 AI 영상을 만들어 보세요
iOS 및 Android에서 VIBE를 무료로 다운로드하세요. 로그인이 필요 없습니다. 10개 이상의 AI 영상 모델에 접근하고 텍스트 프롬프트나 이미지에서 영상을 생성하세요.
더 읽어보기
모든 글 트렌드 & 튜토리얼
틱톡 AI 영상 생성기: 통하는 포맷, 길이, 프롬프트 가이드
2026년 틱톡에 바로 올릴 수 있는 AI 클립의 조건: 세로 화면, 알맞은 길이, 어울리는 사운드, 정직한 표기, 그리고 지금 VIBE에 붙여 넣을 수 있는 프롬프트 5개.
Vincent Park9분 소요 트렌드 & 튜토리얼
오디오 포함 AI 영상 생성기: 자동으로 소리를 추가하는 모델들
VIBE 안의 두 모델은 렌더링하는 순간 오디오를 생성합니다. 어떤 모델인지, 오디오가 어떻게 다른지, 그리고 화면과 실제로 맞는 대화·음향 효과·배경음을 위한 프롬프트 작성법을 알아봅니다.
Vincent Park9분 소요