스크립트로 영상 만들기 AI: 어떤 스크립트든 클립으로 바꾸는 단계별 가이드
스크립트를 AI 영상으로 바꾸는 일은 버튼이 아니라 작업 흐름입니다. 장면으로 나누고, 장면마다 클립을 만들고, 내레이션을 입히세요.
작성자 Vincent Park
게시일
스크립트로 영상 만들기 AI는 쓴 스크립트를 짧은 장면으로 나누고, 장면마다 AI 클립을 만들고, 전체에 내레이션을 입혀 완성하는 작업 방식입니다. 현재 모델은 한 번에 몇 초만 만들기 때문에 스크립트가 설계도이고 클립이 하나하나의 샷이 됩니다. 이 가이드는 단계, 복사해 쓰는 프롬프트, 장면이 따로 노는 실수를 알려 드립니다.
한 문장으로
스크립트로 영상 만들기 AI는 스크립트를 장면으로 나누고, 각 장면을 고유한 텍스트 프롬프트로 AI 영상 클립으로 만든 뒤, 내레이션 아래에서 하나의 완성 영상으로 편집하는 작업 방식입니다.
스크립트로 영상 만들기 AI란 무엇이고 텍스트-투-비디오와 어떻게 다른가요?
텍스트-투-비디오는 프롬프트 하나로 클립 하나를 만듭니다. 스크립트-투-비디오는 더 앞에서 시작해 더 뒤에서 끝납니다. 시작, 중간, 끝이 있는 완성된 스크립트에서 출발해 그 이야기를 따르는 클립 연속물로 마무리합니다. 300단어 스크립트를 3분짜리 영화로 바꿔 주는 모델은 없습니다. VIBE의 모델을 포함해 현재 모델은 약 4~8초 클립을 만들기 때문입니다. 스크립트가 구조를, 모델이 샷을 맡습니다. 개요는 텍스트-투-비디오 모델 위키백과 항목이 중립적이며, 프롬프트 기본기는 AI 영상 프롬프트 가이드에서 다룹니다.
스크립트를 AI 영상으로 만드는 단계는 무엇인가요?
- 스크립트를 장면으로 나눕니다. 한 장면은 하나의 아이디어나 동작이며 보통 내레이션 한 문장입니다. 각 장면을 한 줄로 적습니다.
- 장면마다 화면을 정합니다. 내레이터가 말하는 내용이 아니라 시청자가 보는 것을 한 문장으로 씁니다.
- 룩을 고정합니다. 조명, 색감, 형식(TikTok·릴스·쇼츠라면 9:16)을 하나로 정하고 모든 프롬프트에 같은 표현을 씁니다.
- 아래 예시처럼 장면마다 피사체, 동작, 장소, 카메라, 조명으로 프롬프트 하나를 씁니다.
- 클립을 생성하고 장면마다 가장 좋은 테이크를 남기며 약한 것만 다시 만듭니다.
- 스크립트 전체의 내레이션을 녹음하거나 생성하고 목소리 리듬에 맞춰 클립을 자릅니다.
- 자막을 넣고 게시할 플랫폼의 비율로 내보냅니다.
순서가 중요합니다. 클립을 먼저 만들고 스크립트를 나중에 쓰면 예쁘지만 이야기 없는 영상이 됩니다. VIBE에서 생성은 간단합니다. 모델 섹션에서 모델을 고르고 프롬프트를 붙여넣어 생성하면 되며, 무료 모델은 로그인이 필요 없습니다. 20초 티저든 3분 설명 영상이든 같은 단계가 적용됩니다.
장면 하나는 얼마나 길어야 하나요?
장면을 클립에 맞추세요. 반대가 아닙니다. 대부분의 모델은 약 4~8초 클립을 만들고, Veo 3.1 Fast는 공개된 모델 문서에 따르면 4초, 6초, 8초를 지원합니다. 보통 속도의 내레이터는 그 시간 동안 대략 한 문장을 말하므로 장면당 한 문장이 가장 믿을 만한 규칙입니다. 한 문장에 아이디어가 둘 이상이면 두 장면으로 나누세요. 2026년 10월 기준, 이 한 가지가 결과를 가장 크게 개선합니다.
| 장면 유형 | 일반적인 클립 길이 | 프롬프트에 담을 내용 |
|---|---|---|
| 오프닝 훅 | 4~6초 | 가장 인상적인 화면, 분명한 피사체, 카메라 움직임 하나 |
| 설명 장면 | 6~8초 | 문장을 구체적으로 보여 주는 장면, 추상적 개념이 아님 |
| 디테일·클로즈업 | 4초 | 사물이나 동작 하나, 얕은 피사계 심도, 와이드 샷과 같은 조명 |
| 마무리 장면 | 6~8초 | 행동 유도와 어울리는 완결된 장면 |
 Veo 3.1 Fast
“A woman in a denim jacket opens the door of a tiny corner bakery at sunrise, warm light spilling onto the pavement, slow dolly-in from the street, soft ambient street sounds, shallow depth of field, 9:16 vertical.”
장면마다 프롬프트를 어떻게 쓰나요?
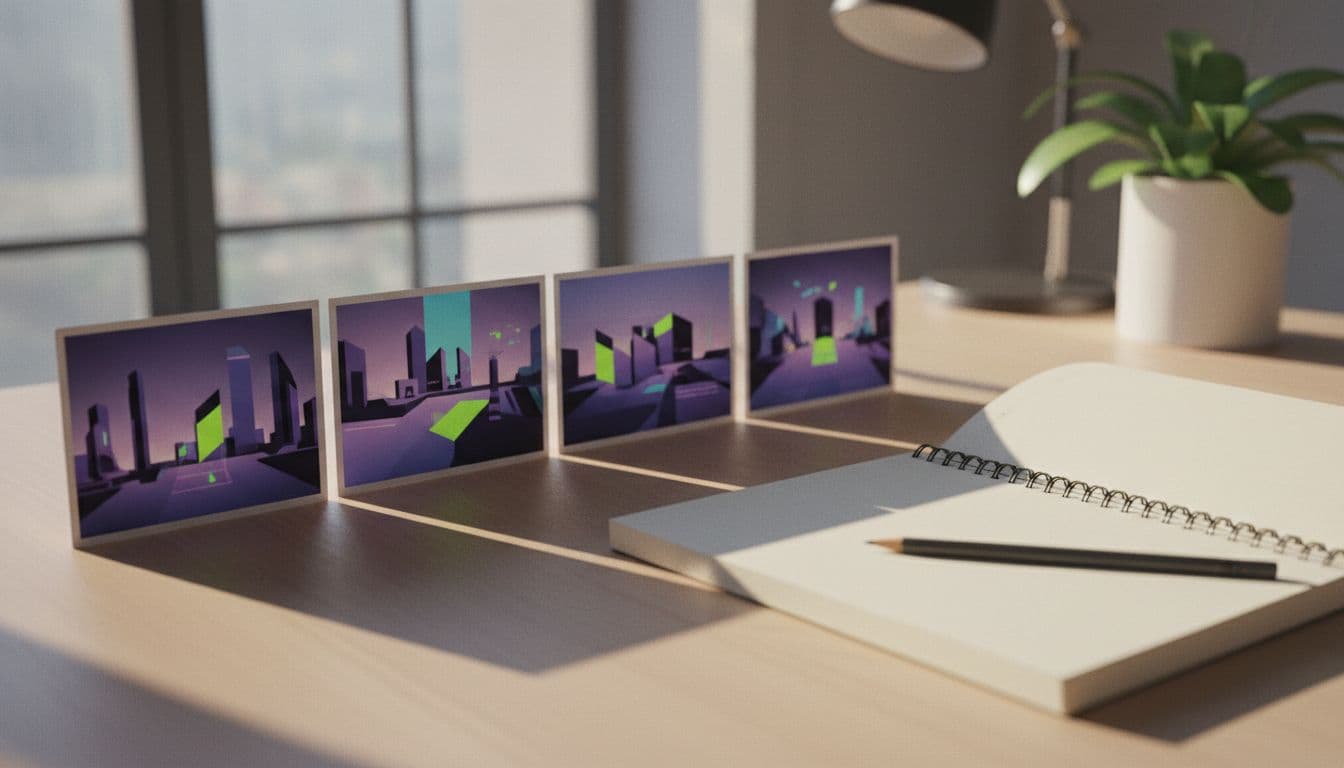
각 장면을 독립된 샷으로 다루세요. 모델은 눈앞의 프롬프트만 보고 이전 클립을 기억하지 못합니다. 일관성을 유지하려면 인물, 장소, 조명 설명을 모든 프롬프트에서 반복하고 동작과 카메라만 바꾸세요. AI 영상의 일관된 캐릭터와 같은 원리를 스크립트 전체에 적용하는 것입니다. 좋은 장면 프롬프트에는 다음이 들어갑니다.
- 피사체: 누가 또는 무엇이 나오는지, 모든 장면에서 같게 묘사합니다(“청재킷을 입은 여성”).
- 동작: 클립 안에서 일어나는 일을 동사구 하나로.
- 장소와 조명: 장소와 시간대, 한 글자도 바꾸지 않고 반복합니다.
- 카메라: 움직임은 하나만. 느린 돌리 인, 핸드헬드, 고정 등.
- 형식: 세로 9:16 같은 화면비.
 Seedance Pro Fast
“Close-up of hands kneading dough on a floured wooden counter, steam rising from a tray of fresh bread behind, the same warm sunrise light through the window, slow push-in, shallow depth of field, 9:16 vertical.”
Veo 3.1 Fast“The same woman in the denim jacket hands a paper bag of bread to a smiling customer across the counter, same bakery interior, same warm sunrise light, gentle handheld camera, natural bakery ambience, 9:16 vertical.”
내레이션과 자막을 AI 클립에 어떻게 맞추나요?
내레이션을 기준으로 작업하세요. 먼저 스크립트 전체의 내레이션을 녹음하거나 생성한 뒤, 각 클립을 해당 문장이 시작되는 지점의 타임라인에 놓습니다. 클립이 문장보다 길면 끝을 자르고, 짧으면 다음 장면으로 일찍 넘어갑니다. Veo 3.1 Fast처럼 영상과 소리를 함께 만드는 모델은 환경음과 대사를 넣을 수 있습니다. 유지할지 내레이션 아래에서 음소거할지는 소리가 있는 AI 영상 가이드에서 설명합니다.
- 내레이션을 하나의 연속 트랙으로 두어 클립 사이에서 속도가 끊기지 않게 하세요.
- 클립 경계가 아니라 말하는 단어에서 자르면 이어 붙인 영상이 아니라 편집된 영상처럼 보입니다.
- 자막은 마지막에 세로 화면의 안전 영역 안에 넣으세요. 짧은 영상은 소리 없이 보는 사람이 많습니다.
- 3단계에서 계획한 화면비로 내보내세요. 헷갈리면 화면비 가이드를 참고하세요.
스크립트에는 어떤 AI 영상 모델이 좋을까요?
모델은 두 가지를 쓰세요. 장면을 시험하는 빠른 무료 모델과 최종 테이크용의 더 강한 모델입니다. 2026년 10월 기준 VIBE의 무료 모델은 Seedance Pro Fast, Wan 2.6, LTX Video, Luma Dream Machine, PixVerse이고, Veo 3.1 Fast는 소리를 만들 수 있는 프리미엄 모델입니다. 자세한 내용은 Seedance 페이지와 Veo 3.1 페이지에서 확인하세요. Veo 계열의 배경은 Google DeepMind의 deepmind.google에 공개되어 있습니다.
| VIBE 모델 | 등급 | 스크립트 작업에서의 용도 |
|---|---|---|
| Seedance Pro Fast | 무료 | 장면별 빠른 테스트 테이크, 최대 8초 720p, 소리 없음 |
| Wan 2.6 | 무료 | Seedance에서 안 되는 장면의 다른 룩 |
| Veo 3.1 Fast | 프리미엄 | 소리와 대사가 포함된 최종 테이크 |
| Kling 3 Pro | 프리미엄 | 핵심 장면의 복잡한 움직임과 인물 |
스크립트로 영상 만들기 AI 작업을 망치는 실수는 무엇인가요?
- 내레이션을 프롬프트에 쓰는 것. 프롬프트는 보이는 것을 묘사하지 말하는 내용이 아닙니다. “매출이 늘었다”는 샷이 아닙니다.
- 장면 사이에 룩을 바꾸는 것. 조명이나 옷이 달라지면 영상 하나가 다섯 개처럼 보입니다.
- 클립 하나에 아이디어 두 개를 넣는 것. 장면을 나누세요. 클립 하나에 동작 하나입니다.
- 화면 글자를 프롬프트로 요청하는 것. 모델의 글자 표현은 불안정합니다. 제목과 자막은 편집 앱에서 넣으세요.
- 처음부터 모두 프리미엄 품질로 생성하는 것. 무료 모델로 테스트하고 프리미엄은 최종 테이크에만 쓰세요.
YouTube에 게시한다면 사실적인 합성 콘텐츠 공개 규정이 완성된 영상에도 적용됩니다. 최신 정책은 YouTube 고객센터에서 확인하세요. 같은 방법으로 채널 전체를 운영하는 흐름은 얼굴 없는 YouTube 채널 가이드에 있고, 첫 스크립트를 시작하려면 VIBE 사용 방법을 보세요.
자주 묻는 질문
스크립트로 영상 만들기 AI란 무엇인가요?
쓴 스크립트를 장면으로 나누고, 장면마다 텍스트 프롬프트로 AI 클립을 만들고, 내레이션 아래에서 편집해 완성 영상으로 만드는 작업 방식입니다.
AI가 스크립트 전체를 자동으로 영상으로 만들 수 있나요?
한 번에는 안 됩니다. 현재 모델은 약 4~8초 클립을 만들기 때문에 전체 스크립트에는 장면별 클립, 내레이션, 편집이 필요합니다. 이 가이드의 방법은 그 과정을 빠르고 반복 가능하게 해 줍니다.
스크립트로 AI 영상을 무료로 만들려면 어떻게 하나요?
스크립트를 장면으로 나누고 VIBE의 Seedance Pro Fast나 Wan 2.6 같은 무료 모델로 각 장면을 생성하세요. 로그인은 필요 없습니다. 내레이션과 자막은 원하는 편집 앱에서 추가합니다.
60초 스크립트에는 클립이 몇 개 필요한가요?
문장당 클립 하나를 계획하세요. 60초 내레이션은 보통 열 문장에서 열다섯 문장이므로 10~15개 장면에 어려운 장면을 위한 추가 테이크를 더해 생각하면 됩니다.
모든 장면에서 같은 캐릭터를 유지하려면?
인물, 장소, 조명 설명을 모든 프롬프트에서 똑같이 반복하고 동작과 카메라만 바꾸세요. 이미지-투-비디오로 같은 참고 사진에서 각 클립을 시작하는 것도 도움이 됩니다.
프롬프트에 대사를 넣어야 하나요?
아니요. 프롬프트는 시청자가 보는 것을 설명합니다. 대사는 내레이션 트랙에 넣습니다. 다만 Veo 3.1 Fast처럼 프롬프트에서 대화를 생성할 수 있는 모델은 예외입니다.
오늘 AI 영상을 만들어 보세요
iOS 및 Android에서 VIBE를 무료로 다운로드하세요. 로그인이 필요 없습니다. 10개 이상의 AI 영상 모델에 접근하고 텍스트 프롬프트나 이미지에서 영상을 생성하세요.